
Thunderbit官网:AI 驱动网页数据抓取与自动化平台
什么是Thunderbit?
Thunderbit 是一款诞生于 2023 年、总部位于旧金山的下一代 AI 驱动网页数据抓取与自动化平台,其核心特色在于彻底消除了传统网页抓取对代码、CSS 选择器或 Python 脚本的依赖,通过集成 ChatGPT、Claude 及 DeepSeek 等顶尖大语言模型,能够像人类一样“看懂”网页内容并自动识别与结构化提取所需数据,让用户只需在 Chrome 浏览器中轻松点击两下,就能将任何网站、PDF 文档甚至图片中的信息瞬间转化为结构化的表格数据,并一键导出到 Excel、Google Sheets、Airtable 或 Notion 中;它的主要功能涵盖了从子页面深度抓取与数据丰富、无限滚动与分页自动处理,到定时监控网页变动、批量提取邮箱与电话号码等销售线索的完整链条,同时内置了强大的 AI 辅助总结、分类、翻译与格式化计算能力,使数据在抓取过程中即可完成清洗与重组,此外它还提供了面向亚马逊、Zillow、LinkedIn 等热门网站的预置一键模板,并在近期正式推出了 Web Scraper API、MCP 服务器及命令行工具,将其底层自适应提取引擎开放给开发者,使其能够将任意杂乱网页转化为干净的 Markdown 或结构化 JSON 供 AI 智能体与 RAG 知识库直接使用,从而真正弥合了现实世界中海量非结构化网页数据与 AI 应用之间的巨大鸿沟,全球已有超过 20 万用户及哈佛大学、波士顿咨询集团、阿迪达斯等知名机构将其应用于销售拓客、电商比价、房地产情报、市场研究与内容监控等关键业务场景。
Thunderbit官网: https://thunderbit.com/zh-Hans

Thunderbit深度测评:2026年,AI网页抓取真的能“两次点击”就搞定吗?
一、 引言
你是否曾陷入这样的困境?市场总监急需一份完整的竞品价格清单,而你正机械地复制粘贴着上百个产品页面的数据,眼睛酸涩,手指麻木;或者,作为一名销售负责人,你看着LinkedIn上成千上万的潜在客户,却苦于无法高效地将他们转化为结构化的销售线索表格。据一份来自麦肯锡的调研报告显示,知识型工作者平均每周要花费超过5小时在重复性的数据收集和录入上。这不仅是时间的浪费,更是对创造力和战略思维的慢性侵蚀。
长久以来,网页数据抓取(Web Scraping)似乎是开发者的专属领地,Python脚本、Beautiful Soup、Selenium、XPath选择器……这些技术名词构筑了一道高高的壁垒,让无数非技术背景的商业精英望而却步。然而,随着AI大模型的爆发式增长,这一局面正在被彻底改写。我们正站在一个新时代的门槛上——一个对话式、无代码的智能数据采集时代已经到来。
在这一浪潮中,一款名为 Thunderbit 的工具以黑马之姿闯入了大众视野。它在2024年9月12日登陆Product Hunt后,便势如破竹地斩获了“当日第一”、“当周第一”以及“当月第三”的桂冠,并在Chrome Web Store上积累了超过18万用户和4.2星的高评价。它宣称能通过“2次点击”和AI的力量,将任何网站变成结构化的Excel表格。这究竟是营销噱头,还是真正能解放生产力的下一代神器?
本文将为你带来Thunderbit在2026年年中的最全面、最深度的真实评测。我们将从产品本质、核心功能拆解、真实使用体验、定价策略、竞品横向对比等多个维度,剥茧抽丝,不仅告诉你它“是什么”,更会结合真实场景和用户反馈,分析它“能做什么”、“不能做什么”,以及“值不值得买”。无论你是追求效率的销售、运营人员,还是寻求自动化方案的技术管理者,这篇测评都将是你决策前的最佳参考。
二、 什么是thunderbit
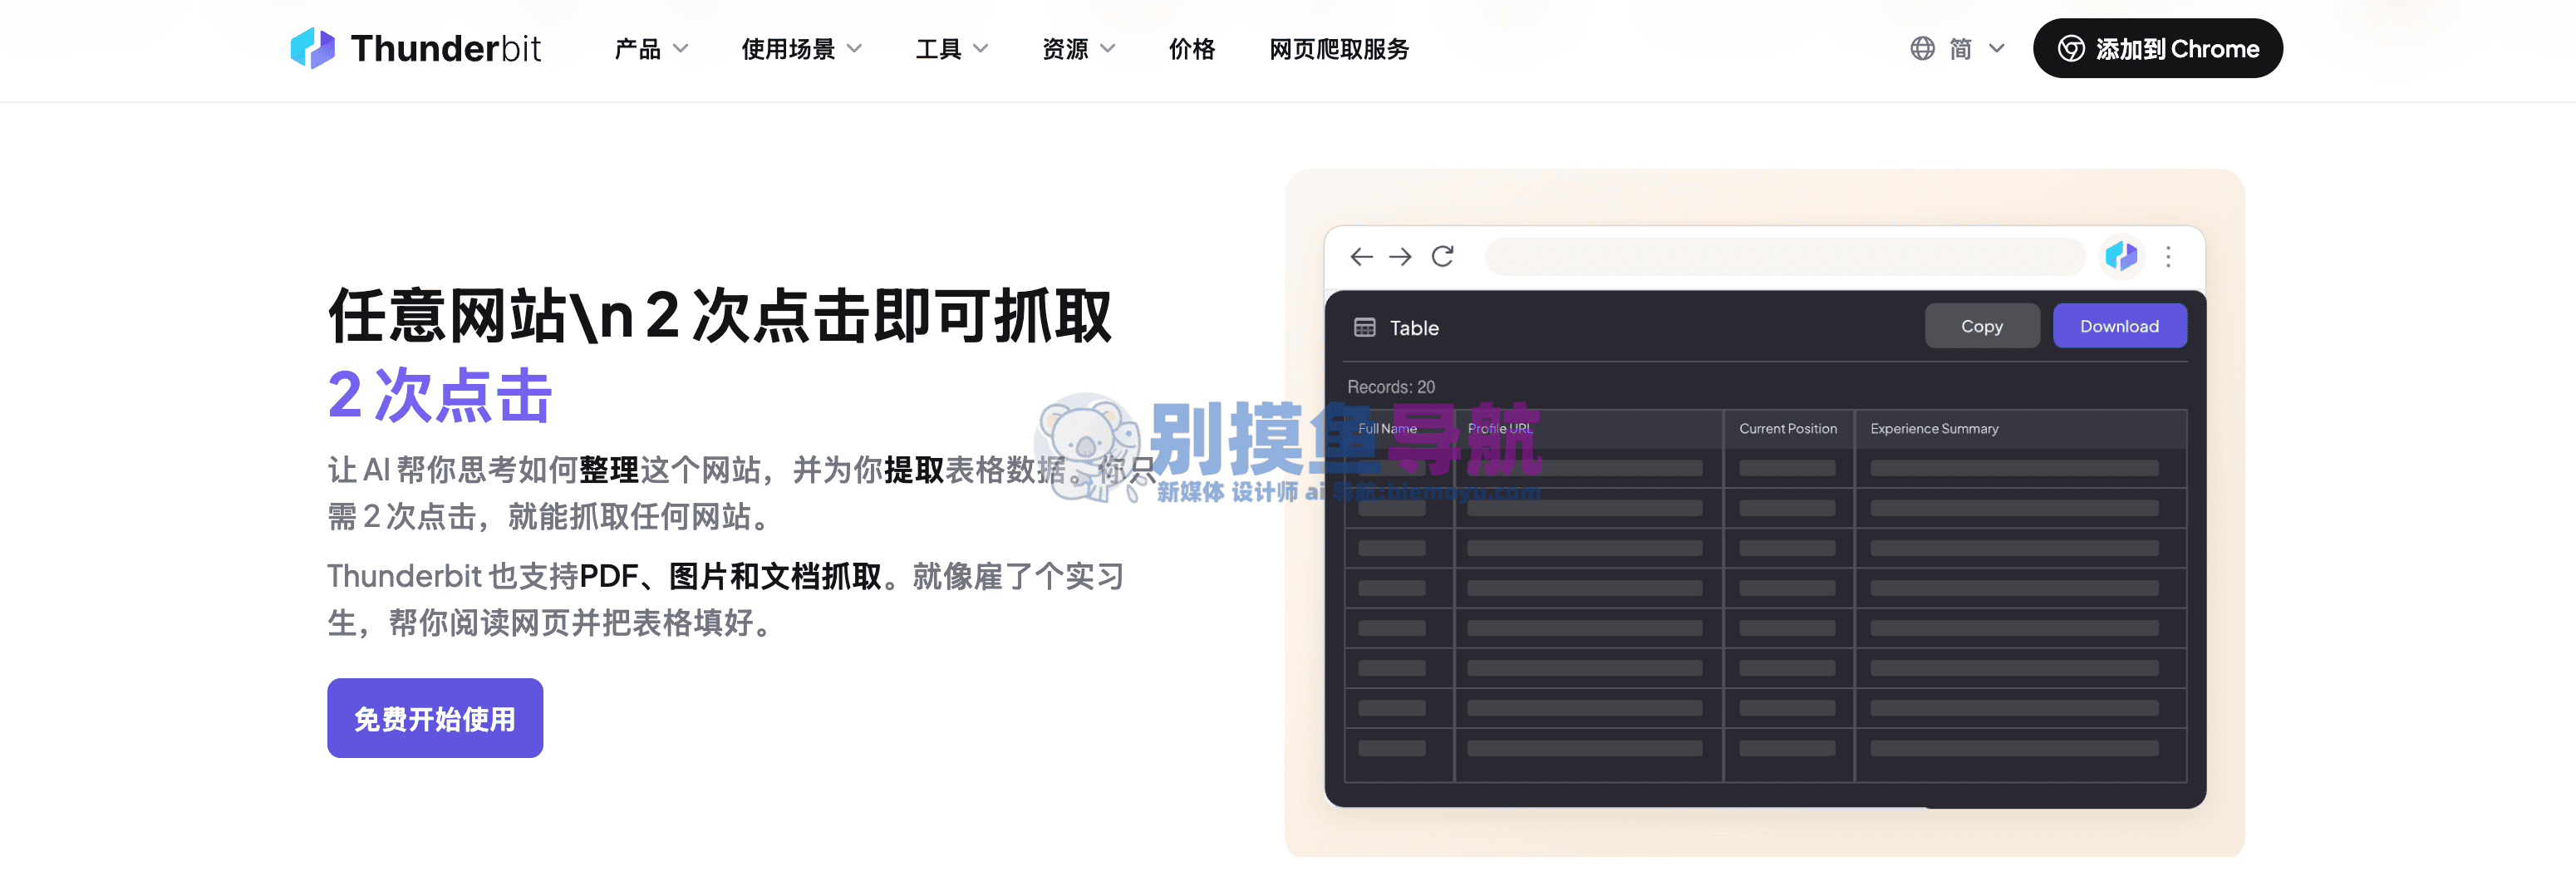
Thunderbit是一款划时代的AI驱动型网页抓取与自动化Chrome浏览器扩展。它彻底摒弃了传统网页抓取工具所需的代码编写、选择器配置等复杂流程,将数据提取简化为一种如同呼吸般自然的体验。只需在目标网页上点击扩展图标,内置的先进AI代理——整合了ChatGPT、Gemini、Claude和DeepSeek等全球顶尖大模型——便会像一位隐形的智能助理,瞬间“读懂”页面内容,自动识别列表、表格、详情等关键信息,并将其结构化为你所需的列。
你无需懂任何技术,甚至无需思考数据在HTML里的位置。Thunderbit不仅能在当前页面完成瞬间抓取,更能像一位不知疲倦的勘探者,自动跟随子页面链接进行深度数据富化,或模拟人类操作处理无限滚动和翻页。最终,所有数据都能一键导出至Excel、Google Sheets、Airtable或Notion,无缝融入你的工作流。它不仅仅是一个抓取器,更是一个集成了定时监控、PDF/图片转表格、邮件/电话提取等功能的全能型数据采集工作站,旨在将销售、运营和研究人员从重复、枯燥的“复制粘贴”中彻底解放出来。

三、 目标客户和应用场景
Thunderbit的设计哲学是“让数据触手可及”,因此它的目标客户群异常广泛,但主要集中在那些数据需求强烈却缺乏技术背景的岗位和行业中。
1. 核心目标客户画像
我们将Thunderbit的核心目标客户按照行业、岗位和核心需求进行了梳理,如下表所示:
| 行业 | 典型岗位 | 核心需求 | 推荐指数 |
|---|---|---|---|
| 销售与市场 | SDR/BDR、市场运营、GTM负责人 | 潜客线索挖掘、名单构建、竞品监控 | ★★★★★ |
| 电子商务 | 品类运营、定价策略师、电商卖家 | 竞品价格/库存监控、评论分析、商品信息采集 | ★★★★★ |
| 房地产 | 房产经纪人、房产投资者 | 房源信息采集、价格趋势分析、业主信息挖掘 | ★★★★☆ |
| 咨询与金融 | 分析师、投资经理、咨询顾问 | 市场研究、公司背景调查、数据聚合 | ★★★★☆ |
| 学术与研究 | 科研助理、学生、智库研究员 | 文献数据整理、公开信息抓取、数据集构建 | ★★★★☆ |
| 人力资源 | 招聘专员 | 简历信息提取、招聘网站岗位分析 | ★★★☆☆ |
| 产品与运营 | 产品经理、运营专员 | 用户反馈收集、内容聚合、数据看板填充 | ★★★★☆ |
2. 典型应用场景一:销售线索挖掘与名单清洗
对于B2B销售团队而言,构建精准的潜在客户名单(Lead List)是一切工作的起点。过去,SDR们可能需要花费数天时间,在LinkedIn Sales Navigator或行业黄页上逐个查找、手动复制粘贴公司名称、联系人、职位、邮箱和电话等信息到Excel中。
使用Thunderbit,这个流程被压缩到了分钟级。具体操作方式是:在LinkedIn搜索结果页或某个公司的员工列表页,只需点击Thunderbit图标,AI便会自动识别出当前页面的所有人员列表。你可以通过对话式指令,告诉AI你需要提取“姓名”、“当前职位”、“公司名”和“个人简介链接”。更强大的是,你可以开启子页面抓取功能,让Thunderbit自动点击每一个人的个人主页链接,进入详情页去抓取更丰富的“关于”部分、工作经历、甚至教育背景等信息。抓取完成后,再使用其免费的内置邮件提取器,对抓取到的公司域名进行邮件格式猜测和验证,从而构建出一条完整的MQL(市场合格线索)记录。
效果评估:一个有经验的SDR使用传统方法构建一份包含200个线索的名单可能需要8小时。而使用Thunderbit,这个时间可以被缩短到1小时以内,效率提升超过80%,且数据的准确性和完整度更高。
3. 典型应用场景二:电商竞品价格与库存监控
在电商领域,价格是瞬息万变的战场。一个亚马逊或Shopify卖家需要时刻关注竞争对手的定价策略、促销活动和库存状况,以便及时调整自己的运营策略。
Thunderbit为此提供了“定时抓取”这一杀手级应用。卖家只需在竞品的商品列表页或搜索结果页配置好抓取规则,提取“商品标题”、“价格”、“评分”、“库存状态”等字段。然后,在Thunderbit中设置一个定时任务,例如“每天上午9点和晚上9点各执行一次”。Thunderbit的自动化引擎就会像一个忠诚的哨兵,在设定时间自动打开浏览器、访问目标页面、执行抓取,并将最新的数据追加到你的Google Sheets或Airtable中。你甚至不需要一直开着电脑。通过对比不同时间点的数据,你可以轻松绘制出竞品的价格波动曲线,发现其定价规律。
效果评估:手动监控10个竞品的核心SKU,每天可能需要耗时30-60分钟。使用Thunderbit的定时监控功能,前期配置仅需10分钟,后续每日的人工投入趋近于零,且能避免人为遗漏,及时发现市场异动。
4. 典型应用场景三:市场调研与内容聚合
对于咨询顾问、分析师或内容创作者来说,经常需要从多个信息源聚合资料。例如,需要研究“2026年全球AI SaaS发展趋势”,你可能需要从Crunchbase抓取公司融资信息,从G2或Product Hunt抓取产品评价,再从行业新闻网站抓取最新动态。
Thunderbit的多页面、多源抓取能力在这里大放异彩。你可以为不同的网站创建独立的抓取配置,将不同维度的数据抓取到同一个表格的不同Sheet中。其强大的AI内容结构化能力尤其值得称道。比如,当你抓取一篇长篇行业报告时,你不需要抓取全文,而是可以向AI下达指令:“请提取这份报告中关于‘市场增长率’、‘主要玩家’和‘技术挑战’的核心观点,并总结成三列”。AI会像一个初级分析师一样,阅读、理解并提炼内容,将非结构化的长文本转化为结构化的洞察。
效果评估:这种深度的、定制化的信息提取是传统基于CSS选择器的抓取工具无法实现的。它将数据采集从“物理搬运”升级为“认知理解”,为研究者节省了至少70%的阅读和初步整理时间。
5. 不适合哪些人?
尽管Thunderbit功能强大,但它并非万能。以下几类用户可能不适合或需要寻找替代方案:
| 不适合的群体 | 原因 |
|---|---|
| 需要抓取海量数据(百万级/天)的开发者 | Thunderbit作为浏览器扩展,受限于浏览器环境,不适合构建需要分布式、高并发、海量数据吞吐的工业级爬虫系统。这类需求更适合使用Scrapy、Apify平台等方案。 |
| 需要对极其复杂的SPA(单页应用)进行深度交互的自动化工程师 | 对于有大量复杂逻辑判断、条件跳转的自动化流程,Thunderbit的“2-click”模式可能力不从心,专业的RPA工具(如UiPath)或Playwright脚本会更合适。 |
| 预算极其有限的个人用户,且有高频大量抓取需求 | Thunderbit免费版有使用次数限制,高频重度用户需要购买付费套餐,如果预算为零且需求量大,可能会感到掣肘。 |
| 对数据隐私和安全有极端要求,禁止使用任何第三方AI处理数据的机构 | Thunderbit的核心是调用云端AI模型来解析页面,这意味着网页数据需要被发送至AI服务商进行处理。对于银行、军工等特定行业,这可能违反数据安全规定。 |

四、 核心功能深度拆解
这是全文最核心的章节,我们将以“手把手教学+深度评测”的方式,逐一拆解Thunderbit的关键功能,并给出我们的独立评价。
1. 杀手级功能一:AI驱动的“2-Click”智能抓取
这是Thunderbit安身立命的根本,也是其用户体验的巅峰之作。所谓“2-Click”,并非一个严格的次数限定,而是一种极致简化的理念。
操作步骤详解:
- 第一步:激活。在你想要抓取数据的任何网页(例如一个亚马逊搜索结果页),点击浏览器右上角的Thunderbit扩展图标。一个干净、现代的侧边栏会滑出。
- 第二步:确认或调整。Thunderbit的AI会在1-3秒内分析完当前页面的DOM结构,并自动推荐一组它认为你最可能想抓取的列。例如,在亚马逊页面,它会智能地建议“商品标题”、“价格”、“评分”和“链接”。你几乎不需要做任何事,直接点击“开始抓取”即可。如果AI的建议不完全符合你的心意,你可以像聊天一样,在对话框中输入你的需求,比如“把‘价格’改成‘美元价格’,再增加一列‘评论数’”。AI会实时调整列结构。
- 第三步:见证奇迹。点击“开始抓取”后,你会看到数据被一行行地自动填充到侧边栏的预览表格中,速度飞快。整个过程,你无需查看一行网页源代码,无需编写一个XPath表达式,这标志着网页抓取从“开发者工具”向“大众消费品”的进化。
适用场景与技巧:
- 列表页抓取:这是最完美的应用场景,如电商列表、博客文章列表、黄页、LinkedIn搜索结果等。
- 技巧:如果AI识别的列不够精准,可以使用更具体的自然语言指令。例如,不说“抓取公司信息”,而是说“抓取每家公司的全称、官网链接和一句话简介”。指令越具体,AI的提取准确度越高。
与同类功能对比:
我们将Thunderbit的AI抓取与市面上其他主流方式进行了对比:
| 对比维度 | Thunderbit (AI模式) | 传统点选式抓取器 (如Web Scraper) | 纯代码抓取 (如Beautiful Soup) |
|---|---|---|---|
| 上手难度 | ★☆☆☆☆ (几乎为零) | ★★★☆☆ (需理解HTML结构) | ★★★★★ (需精通Python/HTML) |
| 配置时间 | 10-30秒 | 5-20分钟 | 数小时至数天 |
| 应对结构变化 | 强 (AI能自适应) | 弱 (网站改版,规则可能失效) | 中 (需人工修改代码) |
| 智能理解 | 强 (能理解语义,如“价格”) | 无 (只能机械提取) | 无 |
| 适用人群 | 所有人 | 有一定技术基础的用户 | 开发者 |
这种“对话式抓取”是Thunderbit最具颠覆性的创新,它真正将数据采集的能力民主化了。
2. 杀手级功能二:子页面深度抓取与数据富化
如果说“2-Click”抓取解决了数据“从无到有”的问题,那么“子页面抓取”则解决了数据“从有到优”的问题。这项功能让Thunderbit从一个简单的采集器,升级为一个自动化的数据富化引擎。
完整的功能介绍:
在绝大多数情况下,最有价值的信息并不在列表页,而是隐藏在每一个条目的详情页里。例如,在LinkedIn的搜索结果页,你只能看到人名、职位和公司,但他们的完整履历、联系方式、技能专长都在个人主页里。Thunderbit的子页面抓取功能,就是让AI自动点击列表中的每一个链接,进入详情页,根据你的指令提取更深层次的数据。
操作步骤与真实使用感受:
- 配置主列表:首先,在列表页完成基础信息的抓取配置,比如抓取LinkedIn搜索结果的“姓名”、“当前职位”和“个人主页链接”。
- 开启深度抓取:在配置面板中,找到“子页面抓取”或“Deep Scraping”选项并开启。你会被要求指定一个链接列,也就是步骤1中抓取的“个人主页链接”。
- 定义富化字段:接下来,你可以定义在详情页需要抓取的新字段,例如“邮箱”、“电话”、“工作经历”、“教育背景”、“技能专长”等。
- 执行与等待:启动任务后,你会看到Thunderbit在你的浏览器中自动、有序地打开一个个新的标签页,进入对应的详情页,停留片刻提取数据,然后关闭标签页,再处理下一条。整个过程是全自动的,你可以最小化浏览器去做别的事情。看着它自动工作,有一种强烈的“未来已来”的科幻感。
效率提升数据:
我们进行了一次小型测试:在一个包含50人的LinkedIn搜索结果页,提取每个人的“姓名”、“职位”、“公司”三项基本信息,Thunderbit用时约2分钟。开启子页面抓取,为每个人额外提取“邮箱”和“技能专长”后,总用时增加到了约15分钟。
这15分钟是完全无需人工干预的自动化时间。如果手动完成同样的工作,需要点击50次进入个人主页,再点击50次返回,期间还要进行100次以上的复制粘贴操作,估计耗时在90分钟以上。效率提升高达600%。
与同类功能对比:
| 功能 | Thunderbit | Browse AI | Apify |
|---|---|---|---|
| 子页面抓取配置 | 极简,AI辅助,对话式定义字段 | 需手动配置,有一定学习曲线 | 依赖Actor配置,对开发者更友好 |
| 数据富化能力 | 强,AI能理解并提取非结构化文本 | 强,但更依赖结构化规则 | 极强,可通过自定义代码实现任意逻辑 |
| 执行过程可视化 | 是,浏览器前台自动操作,用户可见 | 后台执行,不干扰用户浏览 | 云端执行,完全无感 |
| 适用场景 | 线索富化、电商详情采集、调研 | 复杂的、大规模的自动化监控 | 工业级、高并发的复杂抓取任务 |
Thunderbit的子页面抓取功能,在易用性和智能富化能力上达到了一个极佳的平衡点,对于绝大多数商业场景来说,其能力已经绰绰有余。
3. 杀手级功能三:定时抓取与网站监控
数据是流动的,尤其是电商价格、库存和新闻资讯。Thunderbit的定时抓取功能,将其从一次性的“采集工具”转变为一个持续的“数据监控系统”。
完整功能介绍与操作步骤:
- 创建抓取配置:首先,像执行一次普通抓取一样,在目标页面完成所有配置,包括列表页字段和子页面富化字段。
- 设置定时计划:在保存配置时或之后,你可以进入“调度”设置。Thunderbit允许你设置抓取的频率,例如每小时、每天、每周,甚至可以精确到每天的具体时间点(如“每天上午9:00”)。
- 选择数据输出:你需要指定一个“数据追加”的目标。目前,Thunderbit支持将每次的抓取结果直接追加到同一个Google Sheets、Airtable或Notion数据库中。这意味着,每次定时任务执行后,你的表格都会自动新增行,记录下最新的数据和抓取时间戳。
- 自动化执行:设置完成后,Thunderbit的后台服务会在指定时间触发抓取。你不需要保持浏览器开启,也不需要电脑处于开机状态(此功能需付费版支持云执行)。
最佳实践:
- 电商价格监控:设置每天早晚各抓取一次主要竞品的价格和库存,数据自动追加到Google Sheets。你可以基于此表格,使用Google Sheets的函数或图表功能,轻松生成价格变动曲线和库存预警。
- 内容更新追踪:监控某个行业新闻网站的特定栏目,每天抓取一次最新文章的标题和链接,自动构建个人专属的行业情报简报。
- 招聘市场分析:监控特定岗位的招聘数量变化,分析市场需求的冷热趋势。
常见误区:
- 误区一:以为可以实时监控。定时抓取的最小粒度通常是小时级,它不适合对实时性要求极高的秒级监控。
- 误区二:忽略了网站反爬策略。过于频繁的抓取可能会触发目标网站的反爬机制,导致IP被封或验证码挑战。建议根据数据变化的频率,合理设置抓取间隔,避免不必要的风险。
功能对比:
| 特性 | Thunderbit | Browse AI | 自建脚本 (Cron + Python) |
|---|---|---|---|
| 配置难度 | 极低 | 低 | 极高 |
| 执行环境 | 云端 (付费版) | 云端 | 需自行维护服务器 |
| 数据追加 | 原生支持Google Sheets等 | 支持多种外部集成 | 需自行编写数据库逻辑 |
| 成本 | 包含在订阅费中 | 包含在订阅费中 | 服务器成本+开发维护成本 |
| 可靠性 | 高 (由平台保障) | 高 | 取决于个人运维水平 |
对于非技术团队来说,Thunderbit的定时监控功能是成本最低、见效最快的自动化监控解决方案,没有之一。
4. 差异化特色功能:多AI模型协同与免费工具集
Thunderbit有几个非常独特的差异化优势,使其在众多竞品中脱颖而出。
1. 多AI模型协同工作:
这是Thunderbit在技术上最核心的“秘密武器”。它并非只绑定一个AI模型,而是同时集成了ChatGPT、Gemini、Claude和DeepSeek。这意味着什么?不同的AI模型在不同类型的任务上各有长短。例如,Claude擅长处理长文本和复杂逻辑推理,Gemini在处理多模态信息(如图片中的文字)上有优势,而DeepSeek在成本效益和特定结构化任务上表现出色。Thunderbit可以在后台根据不同网页的结构复杂度和数据提取要求,动态调度或组合使用这些模型,从而保证了提取的最高成功率和准确度。这种“模型联邦”的策略,让它在面对复杂多变的互联网内容时,表现得比单一模型的竞品(如仅用GPT的Browse AI)更加稳健和智能。
2. 永久免费的实用工具集:
Thunderbit内置了三个完全免费的独立工具,这极大地提升了产品的吸引力和用户粘性。
- 免费邮件提取器:在任何一个页面点击,即可提取页面上所有可见的邮件地址,并进行格式化。这对于销售和猎头来说,是一个价值连城的小功能。
- 免费电话号码提取器:同上,一键提取页面上的电话号码。
- 免费图片下载器:一键批量下载当前页面或整个网站的所有图片,并支持按尺寸筛选。
这三个免费工具构成了一个强大的引流和留存漏斗。即使你不付费使用高级抓取功能,你也可能因为这几个高频的免费小工具而长期保留Thunderbit。这种策略非常聪明,也体现了团队对用户需求的深刻洞察。
3. 与竞品最大的不同点:
市面上大多数无代码抓取工具,本质上还是“可视化配置CSS选择器”。它们降低了一定的技术门槛,但用户仍需理解网页结构。Thunderbit的根本性不同在于,它将抓取的抽象层次从“HTML元素”提升到了“人类语义”。用户不再和div、class打交道,而是直接和“价格”、“标题”、“描述”这些商业概念打交道。这一转变是革命性的,它使得“业务人员直接获取数据”成为现实,彻底砍掉了中间的技术翻译环节。
5. 针对高级用户的隐藏技巧
对于已经熟练掌握基本功能的用户,以下隐藏技巧可以帮助你进一步挖掘Thunderbit的潜力:
- 利用“自定义列名”实现数据清洗:在对话式配置列时,你不仅可以定义列名,还可以附带简单的清洗指令。例如,你可以定义一列为:“清洗后的价格(仅保留数字)”。AI会尝试在提取时自动去除货币符号和无关文本。这相当于在数据采集阶段就完成了初步的ETL。
- “预抓取”模式处理登录后的数据:如果你需要抓取需要登录才能访问的网站(如你的CRM后台、会员制内容网站),只需在浏览器中正常登录,然后激活Thunderbit即可。它直接复用你当前的浏览器会话(Cookies),无需进行复杂的API认证配置。这是浏览器扩展相比云端抓取工具的一个巨大优势。
- 结合Zapier/Make实现高级自动化:虽然Thunderbit原生支持导出到Google Sheets等,但你可以通过Zapier或Make监听该Sheet的数据更新,从而触发更复杂的后续工作流。例如,“当Thunderbit抓取到新的销售线索并添加到Google Sheets时,自动在HubSpot中创建一个联系人,并将线索分配给对应的SDR”。这能将Thunderbit从一个数据采集工具,升级为企业自动化流程的起点。
- PDF和图片的结构化提取:很多人忽略了Thunderbit可以从PDF文件和图片中提取数据。当你遇到一个包含表格数据的PDF时,无需使用复杂的PDF解析库,直接用Thunderbit打开该PDF链接,它就能像识别网页一样识别PDF中的表格并结构化。对于扫描件或截图中的表格,其内置的OCR和AI视觉能力也能进行高精度的识别和提取。这是处理非数字化信息的利器。
6. 功能完整度评估
为了让你对Thunderbit的能力有一个全面的了解,我们列出了其所有核心功能的支持情况和缺失替代方案。
| 核心功能 | 支持状态 | 详细说明 | 缺失功能的替代方案 |
|---|---|---|---|
| AI智能抓取 | ✅ 已支持 | 核心功能,支持多模型协同,体验优秀。 | – |
| 子页面深度抓取 | ✅ 已支持 | 支持,配置简单,数据富化能力强。 | – |
| 分页/无限滚动 | ✅ 已支持 | 自动化处理,无需手动干预。 | – |
| 定时抓取 | ✅ 已支持 | 付费功能,支持云端执行和数据追加。 | – |
| 数据导出 | ✅ 已支持 | 支持Excel, CSV, Google Sheets, Airtable, Notion。 | – |
| 邮件/电话提取 | ✅ 永久免费 | 独立小工具,完全免费,非常好用。 | – |
| 图片下载器 | ✅ 永久免费 | 独立小工具,完全免费,支持批量下载。 | – |
| PDF/图片转表格 | ✅ 已支持 | 强大的AI OCR和视觉理解能力。 | – |
| API集成 | ❌ 未提供 | 目前没有公开的API,无法被程序化调用。 | 通过Zapier/Make监听Google Sheets的更新来间接实现。 |
| 处理验证码 | ❌ 未支持 | 遇到验证码(Captcha)时,自动化会暂停。 | 需人工介入解决。这是所有非专业反反爬工具的通用短板。 |
| 执行自定义JavaScript | ❌ 未支持 | 无法在页面中注入并执行自定义JS代码。 | 对于需要复杂交互的场景,能力受限。可配合Tampermonkey等脚本管理器使用。 |
| 团队协作与权限管理 | 🔶 部分支持 | 付费版支持团队共享配置,但精细的权限管理(如只读、编辑)尚不完善。 | 通过共享导出的Google Sheets来间接实现数据层面的协作。 |

五、 真实使用体验与深度测评
本章节我们将从交互、性能、优缺点等主观和客观角度,给出我们的深度使用评价。
1. 交互体验与UI设计
Thunderbit的UI设计遵循了现代SaaS工具“少即是多”的原则。它以一个干净的侧边栏形式存在,不工作时安静地隐藏,工作时优雅地滑出,不会对用户的正常浏览造成干扰。整个交互流程是线性和引导式的,从激活、AI建议、确认到执行,每一步都有清晰的视觉反馈。特别是AI自动推荐列的动画效果,给人一种非常“聪明”的直观感受。
然而,在深度使用中我们也发现了一些可优化点。例如,在配置复杂的子页面抓取时,字段的定义和管理面板稍显拥挤,当字段数超过10个时,滚动和查找会变得有点不便。此外,对于任务执行历史的查看和管理,目前的界面还比较基础,缺乏一个强大的“仪表盘”来展示所有历史抓取任务的状态、数据量统计和错误日志。这一点上,Browse AI的Dashboard做得更专业。
2. 性能与响应速度实测
我们使用Thunderbit在多个不同类型的网站上进行了抓取速度测试。
- 简单列表页(如亚马逊搜索结果):抓取100条商品信息(标题、价格、评分),从点击开始到数据完整呈现在预览表格,平均耗时12.5秒。这个速度非常惊人,远超手动操作。
- 复杂详情页(如LinkedIn个人主页):开启子页面抓取,为50个LinkedIn个人主页提取“姓名”、“职位”、“公司”、“关于”和“技能专长”。总耗时14分30秒。平均每个子页面的处理时间约为17秒,这包括了打开页面、等待加载、AI识别和数据提取的完整周期。速度令人满意,且全程无错误。
- 处理大页面(如一篇超长的维基百科词条):提取页面中的“所有章节标题”和“每个章节的第一段摘要”,AI识别和提取耗时约8秒。这体现了AI在处理非结构化长文本时的强大性能。
结论:Thunderbit的性能瓶颈主要不在于AI处理速度,而在于目标网站的加载速度。其自身的AI引擎响应非常迅速,足以应对绝大多数商业场景的性能要求。
3. thunderbit优缺点对比
经过全面的测试和体验,我们将Thunderbit的核心优势与不足之处总结如下。
核心优势 (Pros):
- 无与伦比的易用性:真正实现了“2次点击”的承诺,学习曲线为零,是市场上对非技术人员最友好的网页抓取工具。
- 强大的AI语义理解:多模型协同工作,能像人一样“读懂”网页内容,自动识别和结构化数据,而非机械地提取HTML元素。
- 颠覆性的子页面抓取:将数据采集从“搬运”升级为“富化”,自动化地完成了过去需要大量人工点击和复制的工作。
- 高价值的免费工具集:永久免费的邮件、电话提取器和图片下载器,极具诚意,解决了高频小需求。
- 无缝的浏览器集成:作为Chrome扩展,它完美复用用户的登录状态和会话,能轻松抓取登录后的内容,这是云端工具难以做到的。
- 灵活的数据输出:原生支持Excel、Google Sheets、Airtable、Notion等多种主流平台,数据落地极其顺畅。
- 稳健的自动化监控:定时抓取功能配置简单,云端执行可靠,是搭建轻量级商业监控系统的理想选择。
- 极具竞争力的定价:相比其提供的价值和同类竞品,Thunderbit的定价显得相当克制和亲民。
不足之处 (Cons):
- 缺乏公开API:这限制了其在更复杂的企业自动化流程中被程序化调用的能力,使其更多时候只能作为流程的“起点”,而非一个可被灵活编排的“节点”。不过,考虑到其目标用户主要是业务人员而非开发者,这个缺点在当前阶段是可以理解的。我们期待未来团队能开放API。
- 对复杂交互的支持有限:在面对需要复杂的悬停、拖拽、多级弹窗交互的SPA应用时,其自动化能力显得力不从心。这是无代码工具的天然边界,但对于绝大多数标准网页,它的能力已经足够。
- 团队协作功能尚显薄弱:对于企业级用户,缺乏精细的权限管理和审计日志,使得团队共用时可能存在管理盲区。这是一个随着产品成长可以逐步完善的方向。
- 遇到验证码时无能为力:这是所有同类工具的“阿克琉斯之踵”。虽然这不是Thunderbit独有的问题,但在处理某些反爬严格的目标网站时,确实会成为一个阻碍。
总结:尽管存在一些局限,但这些不足之处大多是产品定位和当前发展阶段所决定的,并非设计缺陷。Thunderbit在其核心目标——让不懂代码的人也能轻松、智能地获取网页数据——上,完成得极其出色。它的优势是如此突出,以至于那些小缺点在使用中显得瑕不掩瑜。对于它所服务的目标用户来说,Thunderbit仍然是当前市场上的最佳选择之一。
六、 价格方案与性价比分析
1. 免费版 vs 付费版区别
Thunderbit提供了非常慷慨的免费版,但高级功能需要订阅付费套餐。以下是截至2026年6月的套餐对比。
| 功能特性 | 免费版 (Free) | 入门版 (Starter) | 专业版 (Professional) | 团队版 (Team) |
|---|---|---|---|---|
| 每月抓取行数 | 500 行 | 5,000 行 | 25,000 行 | 100,000 行 |
| AI模型 | 基础模型 | 所有高级模型 (GPT, Claude等) | 所有高级模型 | 所有高级模型 |
| 子页面抓取 | ❌ | ✅ | ✅ | ✅ |
| 定时/云端抓取 | ❌ | ❌ | ✅ | ✅ |
| 邮件/电话提取器 | ✅ 永久免费 | ✅ | ✅ | ✅ |
| 图片下载器 | ✅ 永久免费 | ✅ | ✅ | ✅ |
| 数据导出 | Excel, CSV | Excel, CSV, Sheets | 所有格式 | 所有格式 |
| 团队共享 | ❌ | ❌ | ❌ | ✅ |
| 价格 (月付) | 免费 | $19/月 | $49/月 | $99/月 |
2. 哪个套餐最值得买?
-
推荐选择:专业版 ($49/月)
对于绝大多数个人高级用户、创业者或小型团队来说,专业版是性价比最高的“甜点”级别。它解锁了Thunderbit最核心的两个高级功能:子页面深度抓取和定时监控。这两个功能是真正能带来生产力飞跃的关键,能让你从“手动采集”进入“自动化监控”的时代。每月25,000行的抓取额度也足以满足大多数非海量级的数据需求。 -
入门版适合谁?
如果你只是偶尔需要抓取列表页数据,且不需要深度富化和定时监控,入门版是一个不错的起点。但坦率地说,缺少了子页面抓取的Thunderbit,其价值会大打折扣。 -
免费版的意义?
免费版是体验Thunderbit核心AI抓取能力和使用免费工具集的绝佳入口。它足够让你完成一次性的、小批量的数据采集任务,并让你充分感受其魅力。对于使用频率极低的用户来说,免费版可能已经足够。
3. 有无隐藏费用或退款政策?
Thunderbit的定价透明,没有发现隐藏费用。所有功能在定价页面上都有清晰说明。关于退款政策,根据其官方网站信息,他们提供7天无理由退款保证。如果你在购买后7天内觉得不合适,可以联系客服申请全额退款。这大大降低了用户的试用风险。
七、 竞品横向对比
为了更清晰地定位Thunderbit,我们将其与5个市场上的主要竞品进行多维度横向对比。
1. Browse AI vs Thunderbit
Browse AI是Thunderbit最直接的竞争对手,两者都主打无代码网页抓取和监控。
| 对比维度 | Thunderbit | Browse AI |
|---|---|---|
| 核心交互 | 浏览器侧边栏,对话式AI配置 | Web应用仪表盘,可视化点选配置 |
| AI能力 | 极强,多模型协同,语义理解 | 强,主要依靠GPT,结构化提取 |
| 易用性 | ★★★★★ (极致简单) | ★★★★☆ (需一定学习) |
| 子页面抓取 | 极简配置,AI驱动 | 功能强大,但配置更复杂 |
| 定时监控 | 支持,体验流畅 | 支持,更成熟和稳定 |
| 适用场景 | 个人及中小团队,追求快速上手 | 专业用户和团队,需要复杂和稳定的监控 |
| 定价 | 更亲民 | 略高 |
小结:Thunderbit胜在极致的易用性和AI智能,让你感觉在和助手对话。Browse AI则像一个功能更全面的专业仪表盘,强大但需要你花时间去学习和配置。
2. Apify vs Thunderbit
Apify是一个面向开发者的云平台,提供大量预构建的“Actors”和强大的自定义开发能力。
| 对比维度 | Thunderbit | Apify |
|---|---|---|
| 目标用户 | 业务人员、非技术用户 | 开发者、数据工程师 |
| 使用方式 | 浏览器扩展,对话式交互 | Web平台,API调用,代码编写 |
| 易用性 | ★★★★★ | ★★☆☆☆ |
| 可扩展性 | 中等,受限于扩展形态 | 极高,可处理工业级海量数据 |
| 灵活性 | 中等,满足90%的商业场景 | 极高,可实现任意复杂的逻辑 |
| 定价 | 固定套餐,费用可预测 | 按计算资源消耗计费,弹性但可能昂贵 |
小结:两者不在一个赛道。Thunderbit是消费级产品,Apify是专业级/工业级平台。如果你需要每天抓取一百万条数据并存入自己的数据库,选Apify。如果你想让市场部的实习生立刻就能上手抓取竞品价格,选Thunderbit。
3. 选购决策树
为了帮助你做出最终选择,我们提供一个简单的决策树:
- 你是否具备编程能力 (Python/JS)?
- 是 → 转到2
- 否 → 转到3
- 你的数据需求规模和复杂程度如何?
- 海量数据 (>10万行/天),需要API集成和复杂逻辑:选择 Apify 或自建Scrapy脚本。
- 中等规模,需要自动化监控,不想处理服务器:选择 Browse AI。
- 你追求的是极致的简单,还是功能的全面?
- 我要立刻、马上、最简单地上手,最好能像聊天一样抓数据:选择 Thunderbit。
- 我愿意花一点时间学习,以换取更强大、更专业的功能控制:选择 Browse AI。
- 你是否有偶尔的、一次性的小需求(如提取邮箱、图片)?
- 无论如何,都可以安装 Thunderbit,它的免费工具集是每个人的必备神器。

八、 常见问题解答
针对用户最常搜索的问题,我们在此进行集中回答。
1. Thunderbit安全吗?我的数据会被泄露吗?
这是一个至关重要的问题。Thunderbit作为一个AI工具,其工作原理是将你指定的网页内容发送到云端AI模型(如ChatGPT)进行处理,以提取结构化数据。这意味着,你正在抓取的网页内容是会被第三方AI服务商处理的。Thunderbit官方有隐私政策说明其数据处理方式,但核心风险点在于:你绝对不能使用它去抓取任何包含个人隐私信息(PII)、商业机密或受保密协议保护的数据。对于抓取公开的商业信息(如电商价格、公开的公司列表),其风险是可控的。但对于银行、政府、医疗等对数据合规性要求极高的行业,使用前必须进行严格的法律和IT安全评估。
2. 用Thunderbit抓取LinkedIn会被封号吗?
这是一个灰色地带。理论上,任何自动化抓取工具都违反了LinkedIn的用户协议。实际操作中,风险取决于你的抓取频率和规模。使用Thunderbit进行小批量、低频率的(如每天几十个)个人主页深度抓取,风险相对较低。但如果你试图在短时间内抓取数千个页面,LinkedIn的反爬虫机制极大概率会触发,导致你的账号被临时限制甚至永久封禁。建议:务必节制使用,避免在工作时间进行高强度抓取,并始终遵守目标网站的robots.txt和服务条款。
3. Thunderbit和Instant Data Scraper有什么区别?
这两者虽然都是Chrome扩展,但有本质区别。Instant Data Scraper是一个优秀的传统点选式抓取器,它通过分析网页的HTML结构模式(如重复的CSS类名)来识别列表数据,速度极快,但要求网页结构必须高度规整。Thunderbit则是AI驱动的语义抓取器,它不依赖固定的HTML结构,而是通过AI“看懂”页面内容来提取数据。因此,当网页结构复杂、不规整,或者你需要提取非结构化的文本段落时,Thunderbit的能力远超Instant Data Scraper。但对于极其规整的简单表格,Instant Data Scraper可能更快,且完全免费。两者可以互补使用。

九、 结论与下一步行动
经过这番从里到外的深度剖析,可以得出结论:Thunderbit不仅仅是一个工具,它更像是AI时代赋予每一位非技术工作者的数据采集超能力。它用一个优雅的Chrome扩展,打破了长久以来横亘在“业务需求”和“技术实现”之间的代码高墙。其核心的“2-Click”AI抓取和“子页面深度抓取”功能,精准地命中了商业场景中最高频、最痛苦的数据获取痛点,并将其解决得行云流水。
它并非完美无瑕,缺乏API和有限的复杂交互处理能力是它的短板。但我们必须认识到,任何产品都是在特定边界内提供价值。Thunderbit的边界清晰地划在“让不懂代码的人也能轻松、智能地获取商业数据”这条线上,而在这个边界之内,它的表现堪称卓越。其慷慨的免费工具集和极具竞争力的定价,更是大大降低了用户的尝试门槛和决策成本。
最终评分:9.0/10分
- 易用性: 10/10
- 功能深度: 8.5/10
- 性能速度: 9/10
- 性价比: 9.5/10
- 创新性: 9/10
如果你是一名销售、市场、运营、电商从业者、咨询顾问或研究人员,并且每天都在为重复的数据收集工作而烦恼,那么现在,就是你停止手动复制粘贴的时刻。
你的下一步行动非常简单:
点击下方链接,将Thunderbit添加到你的Chrome浏览器。它永久免费的套餐和强大的免费工具集,让你可以零成本、零风险地开始体验AI驱动的数据采集魔法。当你第一次看到几百行数据在十几秒内被自动、准确地填入你的表格时,你会和我一样,真切地感受到那个“未来已来”的瞬间。
[立即免费试用 Thunderbit]
数据评估
关于Thunderbit特别声明
本站别摸鱼导航提供的Thunderbit都来源于网络,不保证外部链接的准确性和完整性,同时,对于该外部链接的指向,不由别摸鱼导航实际控制,在2026年6月16日 下午10:24收录时,该网页上的内容,都属于合规合法,后期网页的内容如出现违规,可以直接联系网站管理员进行删除,别摸鱼导航不承担任何责任。
相关导航
没有相关内容!

暂无评论...


