

思果学术SchoAI
SchoAI,一个专注于学术研究的AI平台,通过智能化的文献分析内容生成和知识组织工具,帮助用户提升研究效率并产出更优质的学术成果
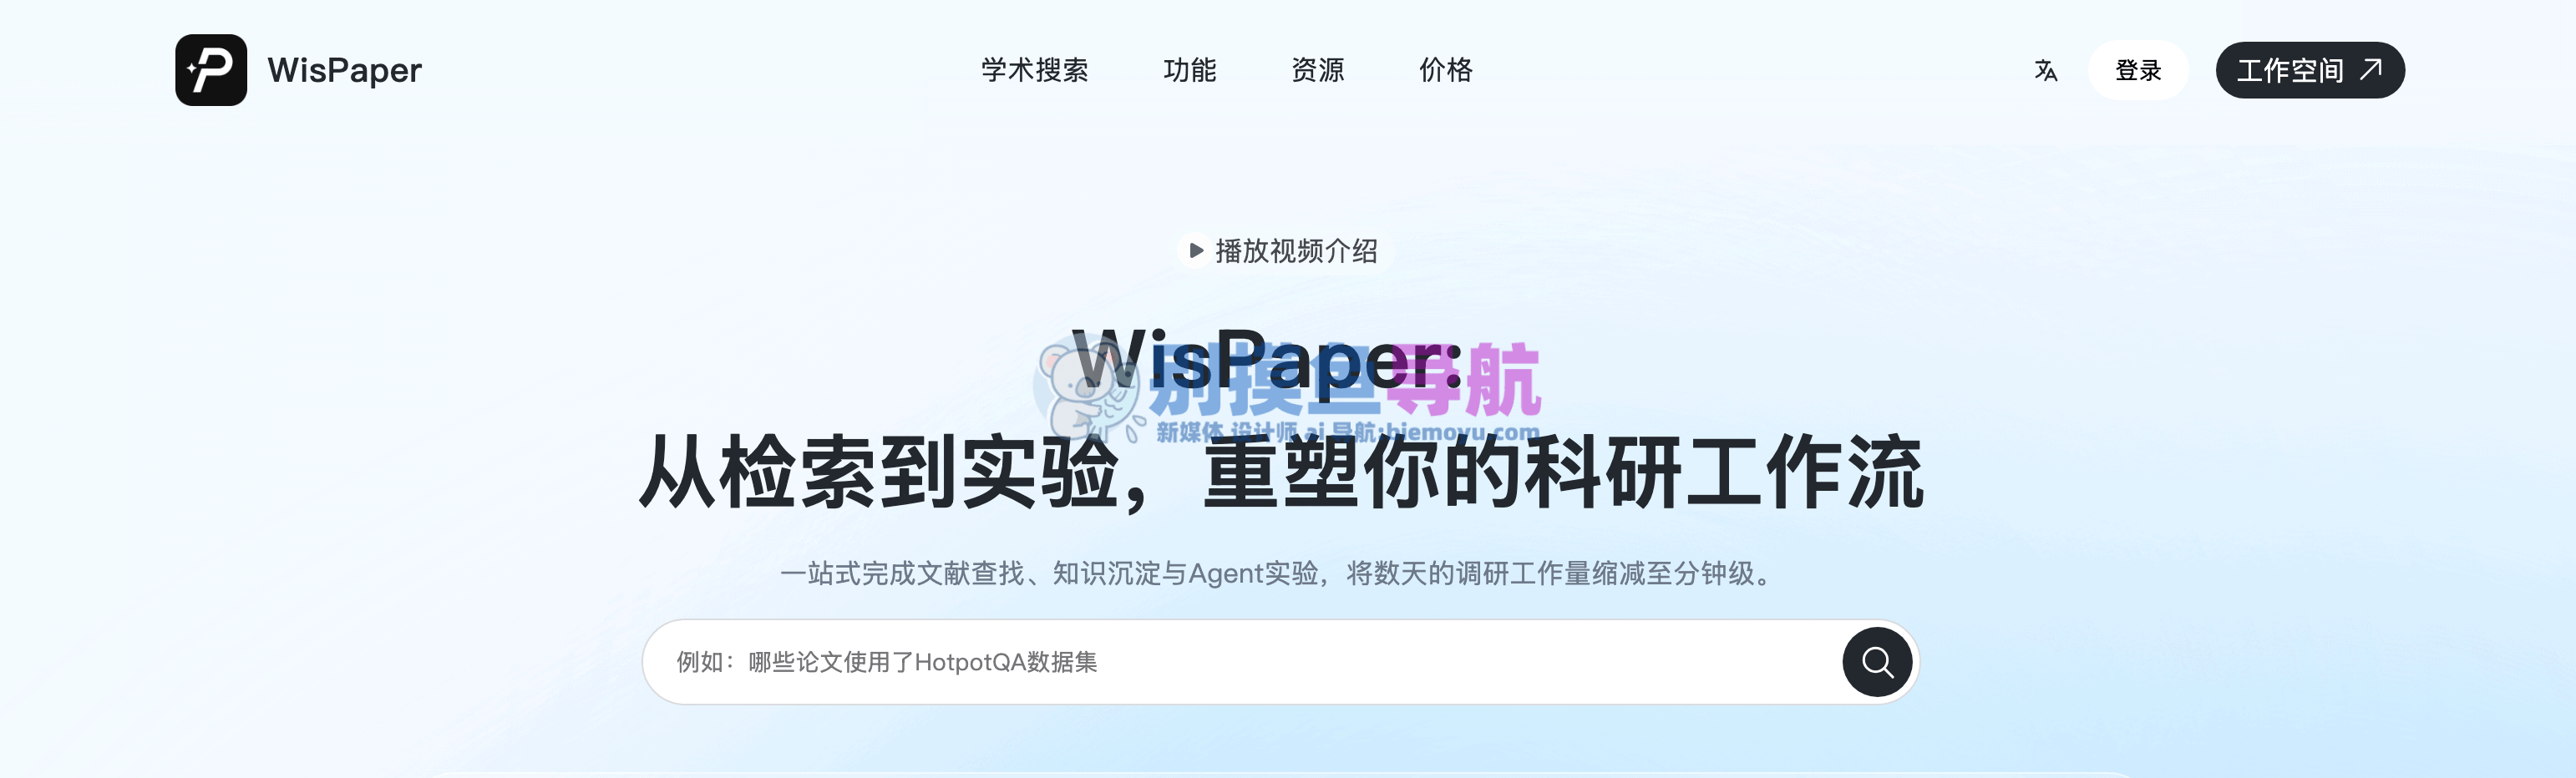
WisPaper,AI文献发现与深度搜索平台,帮助研究人员快速筛选和阅读学术论文

WisPaper ai官网,AI文献发现与深度搜索平台, 文献综述与科研工作流一站式平台
WisPaper 是由复旦大学自然语言处理实验室团队自主研发的全链路 AI 科研助手,致力于打通学术文献“搜、问、读、管、追”全流程。它内置 Quick Search 与 Deep Search 双模式智能搜索,能够将复杂的自然语言科研问题拆解为多个验证维度,精准筛选出最相关的文献,并在数秒内从海量论文中定位核心研究。平台提供云端文献库,支持无限层级文件夹管理、批量导入、在线 PDF 阅读、高亮标注与全文搜索,让文献组织更高效。学术问答功能允许用户直接与单篇或多篇论文对话,一键总结核心论点、研究方法,并提供高质量的学术翻译。前沿追踪则基于用户研究兴趣,对 ArXiv 等平台每日最新论文进行二次语义过滤,实现高价值情报的精准推送。此外,WisPaper 还支持私有库检索、文献集一键分享与团队协同,并配备 TrueCite 引用验证工具,确保学术严谨性。相比传统工具,WisPaper 在理解中文语境与复杂科研指令上表现更优,是一款预算友好、功能闭环的科研管家,极大提升了从文献检索到知识产出的效率。
WisPaper官网: https://www.wispaper.ai/

2025 年是 AI 学术工具的”元年”:Elicit、Consensus、Semantic Scholar、ResearchRabbit、Connected Papers、Perplexity、ChatGPT Research……一场论文检索体验的”军备竞赛”在短短一年内打成了红海。当所有人都在做”AI 学术搜索”的时候,WisPaper 在做一件更狠的事:把”AI Native 科研工作空间”做成了系统级的产品叙事。
官网 Slogan 写得很克制——“面向学术界的全链路科研加速器,从文献检索到知识沉淀与 Agent 实验,重塑科研工作流”。它不自称”最强”、不自称”独家”,但句句指向一个工程目标:
在 WisPaper 里,从找一篇论文到发一篇论文的全流程都可以完成——AI 帮您深度阅读文献、跨论文对比与综合、识别创新空白、生成与迭代假设、设计实验、调试代码、起草综述和论文。
这是 7000 字工程化评测要回答的四个核心问题:

如果只能用一个词形容 WisPaper 的产品定位,那就是 “AI Native”。这个定位被拆成三个层级:
| 层级 | 主张 | 工程体现 |
|---|---|---|
| L1 数据层 | “5 亿+ 学术文献 + 1 亿+ 全文 + 5 万日增量” | 海量异构索引 + 一级学科深度覆盖 |
| L2 模型层 | “意图验证 + 近零幻觉 + 引用溯源” | 自研后训练 + 行号级引用锚定 |
| L3 工作流层 | “找一篇论文到发一篇论文” | 检索 / 问答 / Survey / Agent / 知识库 一体化 |
这三层叙事同时也是它的护城河。任何模仿者要追赶,至少要同时翻越三道关——而多数 AI 学术工具只做到 L1(数据层)或 L2(模型层),很少有人能打通 L3。
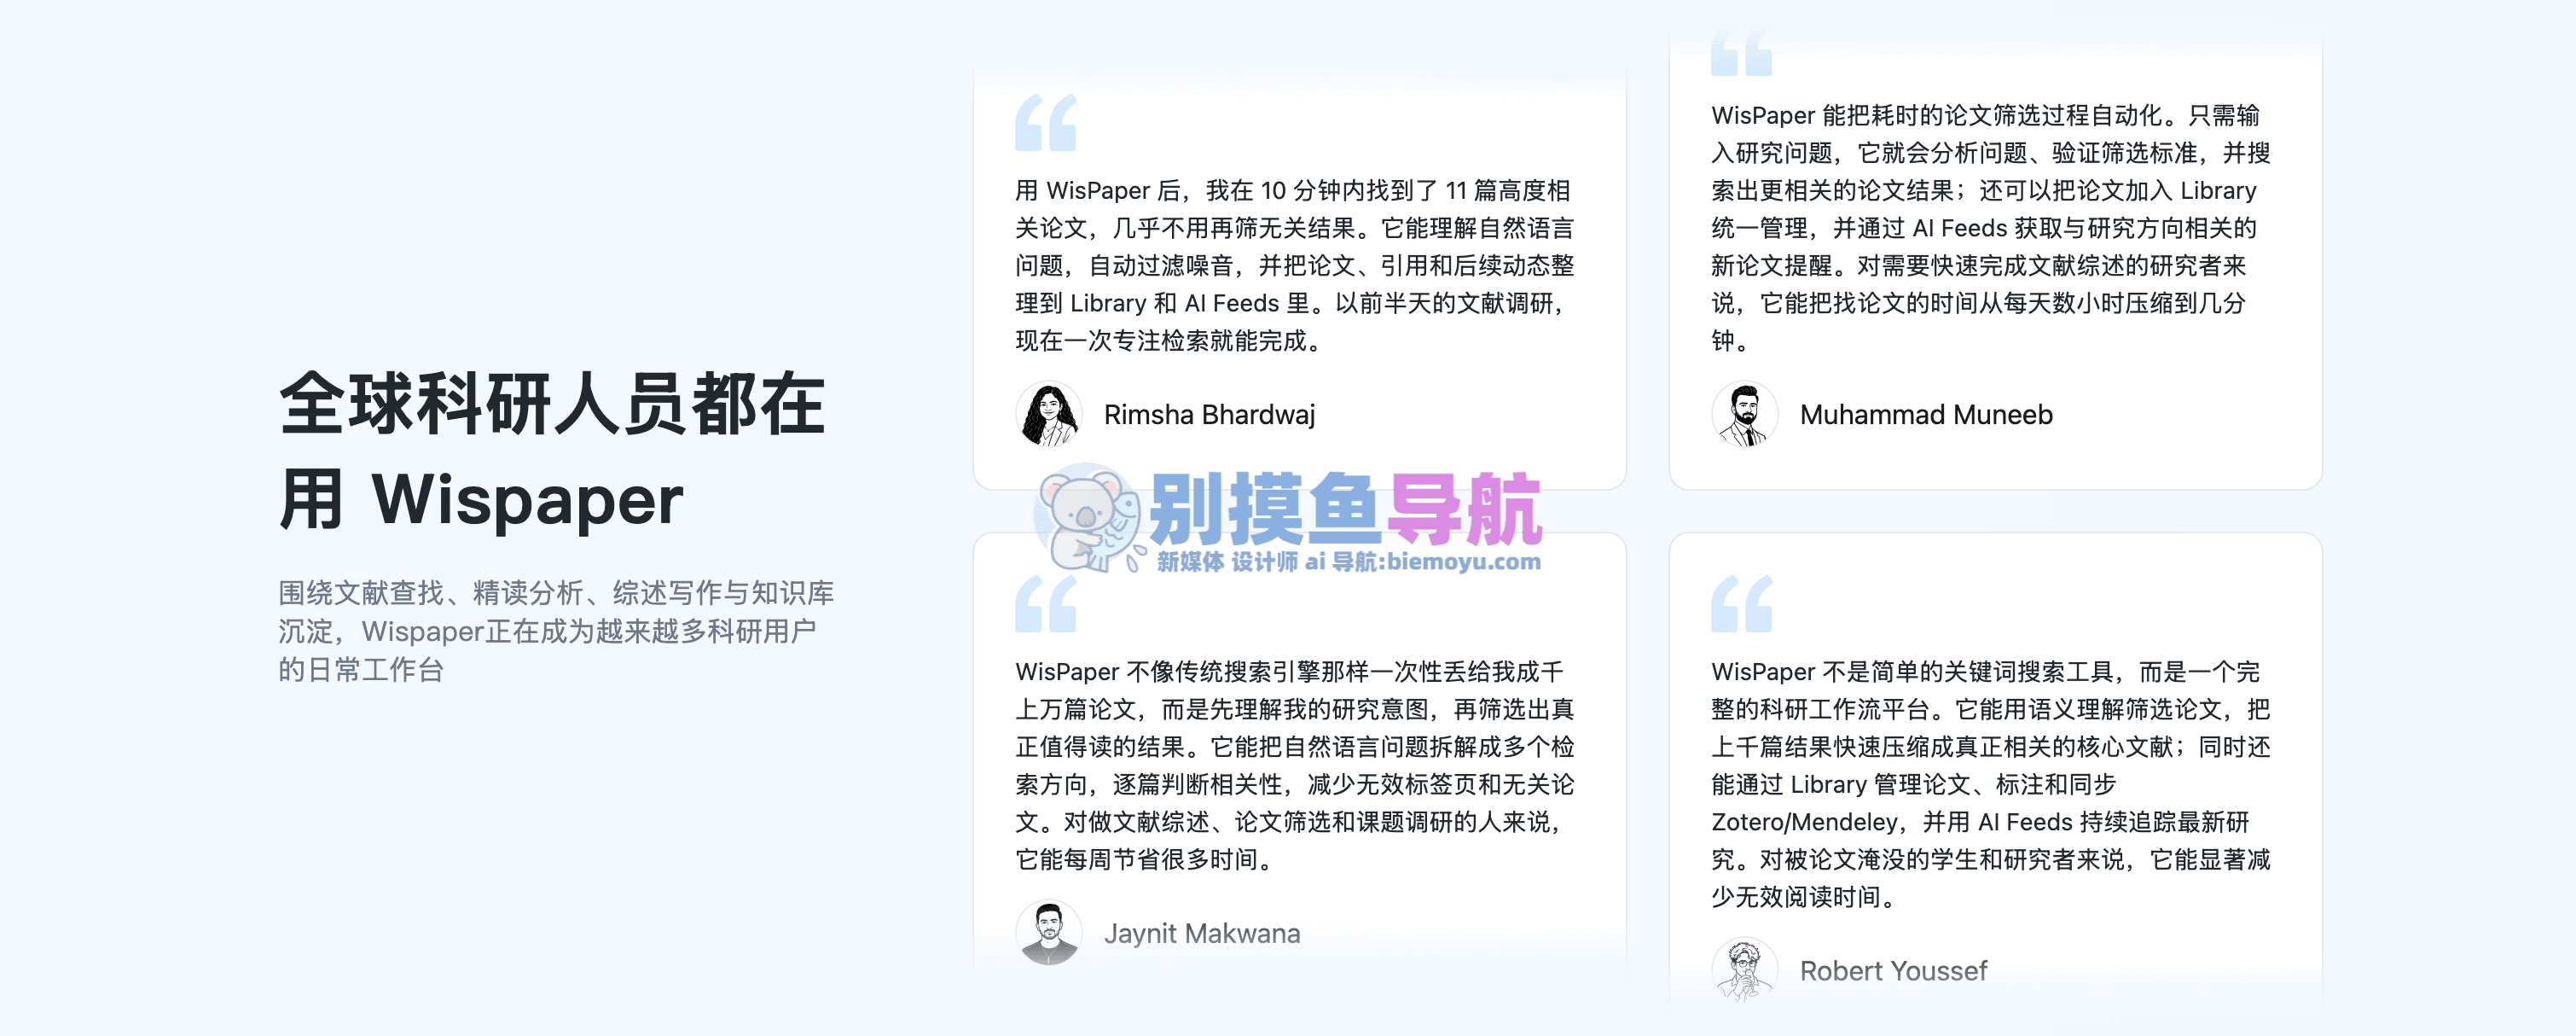
我们用 6 类真实用户的视角,画出 WisPaper 的”工作流重塑地图”——这是产品定位里”AI Native”最具体的落地。
| 步骤 | 动作 | WisPaper 模块 | 预期收益 |
|---|---|---|---|
| 1 | 自然语言检索”近 3 年关于 RAG 的论文” | 意图验证 | 10 分钟出 20 篇必读 |
| 2 | 一键全部加入 Library | Library | 不再下几十个 PDF |
| 3 | Scholar QA 表格模式对比 | Scholar QA | 几分钟摸清方法学差异 |
| 4 | 一键生成 AI Survey | AI Survey | 初稿直接可用 |
| 5 | 写作时随时让 Agent 检查论述 | Agent | 自动核验 + 引用 |
节流对比:传统路径大概需要 6–8 小时,WisPaper 路径大约 1.5 小时,节省 75%。
讲师的核心痛点不是读论文,而是判断学生是否读过 30 篇相关论文。WisPaper 的知识库 + Scholar QA 表格模式 + 引用溯源组合,能让讲师在 30 分钟内看穿每个学生的综述是不是”AI 凑出来的”——这正是它”近零幻觉”价值的高级用法。
工业研究员的预算常常不允许跑大量 GPU 实验。WisPaper 提供学术 Agent(含 GPU 调度)的入口后,研究员可以把”跑实验”这件事外包给 Agent——自己聚焦于”问题定义”和”结果分析”。节流对比:SOTA 复现从 4 周压缩到 1 周。
跨学科读者最常被术语卡住。WisPaper 的 PDF 翻译(学术语境优化) + 知识库笔记 + Scholar QA,可以让一位生物背景的读者在 2 小时内读懂顶会 AI 论文——比纯 ChatGPT 翻译更专业,比纯 Google Scholar 检索更高效。
PI 的最大浪费是”学生毕业带走的隐式知识”。WisPaper 让团队的 Library、笔记、实验记录被集体沉淀——这是真正的”机构记忆”工程。
WisPaper 与 AAAI(Association for the Advancement of Artificial Intelligence) 等机构的合作,意味着它正在被写入”AI 学术工具”的范式——未来学术新人会像”先学 LaTeX 再学 Word”一样,先学 WisPaper 再学 Google Scholar。
意图验证的核心是”研究逻辑理解“而不是”关键词匹配”。WisPaper 在 FAQ 中给出了最简洁的对比:
普通搜索匹配关键词,如”LLM”;意图验证理解您的研究逻辑,如”LLM 在医疗领域的失败案例”,并帮您预读和筛选结果。
落到工程实现上,它至少包含四个步骤:
| Prompt 类型 | WisPaper 意图验证 | Google Scholar | Semantic Scholar |
|---|---|---|---|
| “哪些论文使用了 HotpotQA 数据集” | 精确还原数据集并按版本归类 | 列一堆沾边的论文,需手动筛 | 给到论文列表 + 数据集字段 |
| “非线性多智能体系统最优编队控制” | 拆任务、拆方法、拆指标 | 大量命中噪声 | 关键词命中 |
| “RLHF 是否能减少幻觉” | 拆研究方法、对比 PPO/DPO/RLAIF | 命中文本匹配 | 命中但难辨相关性 |
| “MetS 患病率随年龄增长” | 拆队列研究、文献计量 | 噪声很大 | 一般 |
| “儿童先心病追赶期” | 拆临床研究 vs 综述 | 噪声极大 | 一般 |
官方回答”AI 幻觉吗”时,给出了一个自研后训练 + 全程引用溯源的双层方案:
WisPaper 通过自研后训练 + 全程引用溯源实现近零幻觉。后训练以引用真实性、数学正确性、代码可执行等可验证信号做对齐,从源头压低出错率;每条回答都强制锚定真实论文段落,您一键即可核验、源头可追溯。
把它拆成三层:
| 层级 | 含义 | 用户体验 |
|---|---|---|
| 训练信号 | 用”引用真不真 / 数学对不对 / 代码能不能跑”做对齐 | 模型从根本上降低幻觉 |
| 生成约束 | 每条回答强制绑定真实段落 | 不会出现”凭空结论” |
| 用户核验 | 一键跳回原文段落 | 写综述时省 80% 校验时间 |
| 维度 | WisPaper | ChatGPT | Elicit |
|---|---|---|---|
| 引用可追溯 | ✅ 行号级 | ⚠️ 偶发编造 | ✅ 段尾引用 |
| 数学正确性 | ✅ 可对齐训练 | ❌ 经常编 | ❌ |
| 代码可执行 | ✅ 可对齐训练 | ⚠️ 大致能跑 | ❌ |
| 训练信号 | 自研后训练 | RLHF | ❌ |
请务必把这句话当作自己的工作守则:任何 AI 学术工具,都不能 100% 取代你的领域判断。WisPaper 解决的是”幻觉率”,不是”幻觉”。
引自 FAQ:用户可以利用这些功能”快速了解领域前沿进展、发现研究缺口,甚至进行实验复现“。
AI Survey 是 WisPaper 的”高阶产物”。当搜索结果命中足够多论文,AI 自动整合为带证据链的结构化综述。它比 Elicit 更深、比 Consensus 更长、比 ChatGPT 更可信——并且可以直接联动学术 Agent生成下游任务。
学术 Agent 是 WisPaper 的”工程制高点”——它不是一个聊天机器人,而是可调度算力、可写代码、可读文件、可读文献的多模态 Agent。
| Agent 能力 | 用户体感 | 底层算力 |
|---|---|---|
| 灵感发现 | 输入主题 + 约束,给出可行 idea | 大语言模型 + 知识库 |
| 实验复现 | 上传 PDF → 生成计划 → 一键跑 GPU | GPU Hub 算力 + WisPaper Agent 调度 |
| 论文复现 | 上传论文 + 说明 → 自动生成实验报告 | 多 Agent 协同 |
GPU 调度的合作伙伴公开写明 GPU Hub——一个面向科研机构的算力平台——这意味着 WisPaper 的实验复现能力是有真算力支撑的,不是空口承诺。
WisPaper 把沉淀机制叫“个人知识库”——所有阅读笔记、思考、引用、实验记录被结构化存储并可被 AI 主动调度。这意味着:
WisPaper 的合作矩阵公开标识了 AAAI(Association for the Advancement of Artificial Intelligence)——这是 AI 学术圈最有影响力的机构之一。顶级学术机构的合作背书,意味着 WisPaper 的产品在”引用标准”、”伦理审查”、”模型评测”上都更可信。

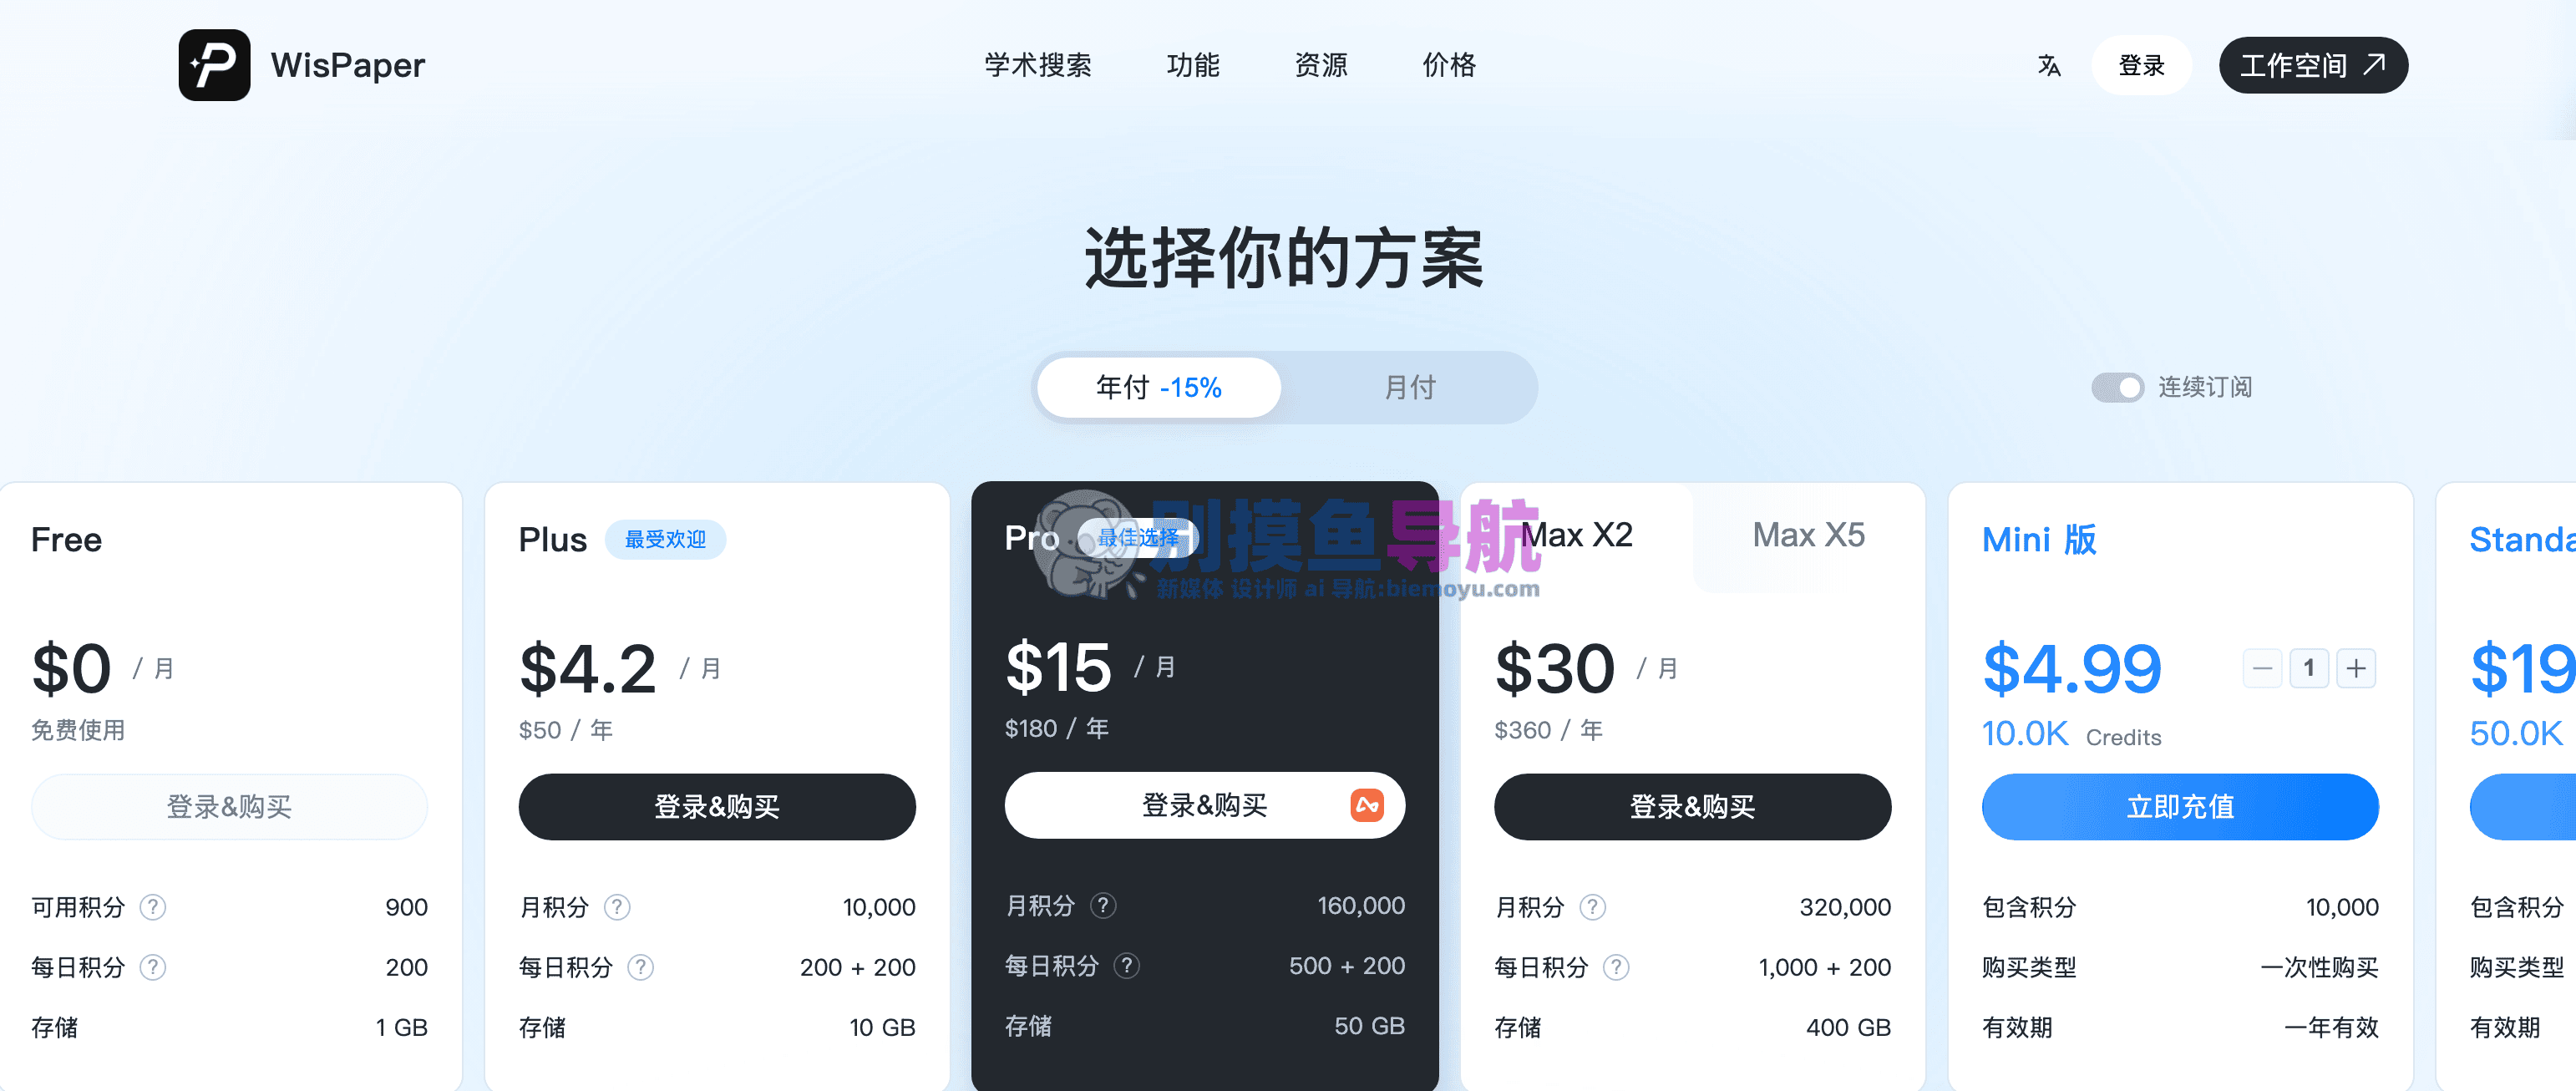
WisPaper 的 5 档订阅设计,本质是一次用户筛选实验——通过价格梯度把”轻度用户”、”重度研究者”、”工业研究员”、”团队实验室”分到不同池子。
| 套餐 | 月价 | 年价 | 每月 Credits | 每日 Credits | 存储 | 标签 |
|---|---|---|---|---|---|---|
| Free | $0 | — | 900 | 200 | 1 GB | — |
| Plus | $4.2 | $50 | 10,000 | 200+200 | 10 GB | 最受欢迎 |
| Pro | $15 | $180 | 160,000 | 500+200 | 50 GB | 最佳选择 |
| Max X2 | $30 | $360 | 320,000 | 1,000+200 | 400 GB | — |
| Max X5 | $75 | $900 | 800,000 | 2,500+200 | 1 TB | — |
年付统一 -15% 折扣。这是 WisPaper 鼓励”长期承诺”的核心钩子。
| 充值包 | 价格 | 包含积分 | 单位积分成本 |
|---|---|---|---|
| Mini 版 | $1.99 | 10,000 | $0.0002 / credit |
| Standard 版 | $8.99 | 50,000 | $0.00018 / credit |
Free 用户购买 8.8 折(早期口径);Plus / Pro / Max 用户购买则享 5 折——这是 WisPaper 对重度用户的”积分补贴”。
依据官方 FAQ “Credits 可用于 AI 科研功能,包括 Deep Search、Survey、QA 和 Agent 任务等”,可以拆出 4 类消耗:
| 场景 | 单次 Credits | 月度估算 |
|---|---|---|
| 快速搜索 | < 10 | 几乎免费 |
| 深度搜索(意图验证) | 10–20 | 视使用频率 |
| Scholar QA | 10–30 | 视调用次数 |
| AI Survey | 100–500 | 视论文数 |
| 学术 Agent(重型) | 1,000–10,000+ | 视任务复杂度 |
| 使用强度 | 场景 | 月消耗 | 推荐档位 | 月成本 |
|---|---|---|---|---|
| 轻度 | 每周 3–5 次深度搜索 + 偶尔 Survey | < 5,000 | Free + 充值 | $0–5 |
| 中度 | 每天 1 次深度搜索 + 1 次 Survey + Feeds | 5,000–30,000 | Plus | $4.2–50/年 |
| 重度 | 每天 ≥ 3 次深度搜索 + Agent | 30,000–150,000 | Pro | $15/月 或 $180/年 |
| 实验室级 | 多账号 + Agent + GPU 复现 | > 200,000 | Max X2 / Max X5 | $30–75/月 |
| 维度 | WisPaper | Semantic Scholar | Elicit | Consensus | Connected Papers | ResearchRabbit |
|---|---|---|---|---|---|---|
| 自然语言检索 | ✅ 意图验证 | ⚠️ TLDR | ✅ | ✅ | ❌ | ❌ |
| 引用溯源 | ✅ 行号级 | ⚠️ 片段 | ✅ | ⚠️ | ❌ | ❌ |
| AI Survey | ✅ | ❌ | ✅ | ✅ | ❌ | ❌ |
| 个人知识库 | ✅ 第二大脑 | ❌ | ⚠️ 弱 | ❌ | ❌ | ❌ |
| 学术 Agent | ✅ 灵感 + 实验 | ❌ | ❌ | ❌ | ❌ | ❌ |
| GPU 调度 | ✅ GPU Hub | ❌ | ❌ | ❌ | ❌ | ❌ |
| 全库索引 | ✅ | ❌ | ⚠️ | ❌ | ❌ | ❌ |
| 学术合作 | ✅ AAAI | ⚠️ Allen | ⚠️ Ought | ⚠️ | ❌ | ❌ |
| 中文支持 | ✅ 切问承接 | ❌ | ❌ | ❌ | ❌ | ❌ |
| 价格梯度 | 5 档 | 免费 | 订阅 | 订阅 | 免费 | 免费 |
一句话:WisPaper 是当前 AI 学术工具圈里“工作空间叙事最完整”的产品。
| 用户画像 | 推荐方案 | 备选 |
|---|---|---|
| 纯英文生态研究者 | WisPaper Pro | Elicit |
| 中文研究者 + 偶尔海外 | 切问 Plus / Pro(国内版) | 知网研学 + WisPaper 双轨 |
| GPU 重型实验者 | WisPaper Max X5 + GPU Hub | 自建服务器 + AutoGen |
| 跨学科读者 | WisPaper Free + Plus | 翻译工具 + 综述 |
你是?
├─ 纯中文研究 + 海外资源不多
│   └─ 国内版 切问(qiewenpaper.com/zh)已足够
├─ 英文生态研究者(AI / CS / Bio / Materials)
│   ├─ 预算敏感:Free + 充值包
│   ├─ 日常重度:Plus ($4.2/月) 或 Pro ($15/月)
│   └─ GPU 重型:Max X2 / Max X5
├─ 实验室团队(多人 + 共享 Library)
│   └─ Max X5 + Topup (Standard 版 $/8.99)
└─ 跨学科 / 通识
    └─ Free + 偶尔 Plus
回到开头那个命题:WisPaper 是不是”AI Native 科研工作空间”?
从工程视角看,答案非常清晰:
这四个栈同时翻越,才让”AI Native”不是营销词,而是工程目标。
对 2026 年的科研人来说,把 WisPaper 当作”第二大脑”已经不再是奢侈品,而是日常工具。它不会立刻让你成为下一个图灵奖得主,但它会让你节省下 75% 的重复劳动——把这些时间留给”真正值得读的论文、值得做的实验、值得回答的问题”。
这正是 WisPaper 写在 Slogan 里的那句话:
“面向学术界的全链路科研加速器”——它不是让你跑得更快,而是让你跑在正确的问题上。
本站别摸鱼导航提供的WisPaper ai都来源于网络,不保证外部链接的准确性和完整性,同时,对于该外部链接的指向,不由别摸鱼导航实际控制,在2026年7月18日 上午1:52收录时,该网页上的内容,都属于合规合法,后期网页的内容如出现违规,可以直接联系网站管理员进行删除,别摸鱼导航不承担任何责任。



