
XCrawl官网入口:一款面向AI工作流优化的智能爬虫API,将任意网站内容一键转换为结构化的JSON、Markdown格式及截图
简介
XCrawl是一款面向AI工作流优化的智能爬虫API,核心技术亮点在于”LLM-ready数据输出”与”零配置反爬”。平台采用无头浏览器渲染技术,完美处理SPA单页应用、无限滚动及前端动态加载内容,自动提取关键元素生成结构化数据。不同于传统爬虫需要手动清洗HTML,XCrawl直接输出干净的JSON表格、Markdown正文及元数据,无需后处理即可喂给GPT、Claude等大模型。内置的全球代理轮换与智能行为模拟系统,自动绕过reCAPTCHA验证与IP封禁,确保大规模数据采集稳定性。支持Python、Node.js/TypeScript等主流语言SDK,提供REST API与n8n、Zapier等无代码平台集成,让开发者通过几行代码即可构建实时数据流水线。
XCrawl官网: https://www.xcrawl.com/zh/

XCrawl:2026年最值得关注的 AI 驱动智能爬虫 API,一个工具打穿数据采集全链路
当大多数人还在为反爬拦截、HTML 清洗、格式转换这些老问题头疼的时候,AI 爬虫这个赛道已经悄悄发生了质变。XCrawl 的出现,让”爬取→结构化→喂给 LLM”这整条链路,第一次真正做到了开箱即用,更多查看玩龙虾导航: https://wanlongxia.com。
这不是一个小打小闹的开源项目。XCrawl 是一套完整的 Web 数据基础设施,面向 AI 工程师、独立开发者和企业级数据团队设计,覆盖单页抓取、全站爬取、SERP 采集、URL 映射四大场景,并且原生支持 MCP 协议,能让 Claude、GPT 等大模型直接调用,真正实现”即爬即用”。
它到底是什么
XCrawl 是一个 AI-ready 的智能网络数据抓取 API 平台。 它的核心定位不是传统意义上的爬虫库,而是一个面向 AI 工作流设计的 Web 数据基础设施。
传统爬虫的工作模式是:写选择器 → 抓 HTML → 清洗数据 → 格式转换 → 喂给模型。每个环节都要人工介入,维护成本极高,遇到反爬还得单独处理代理、指纹、验证码。
XCrawl 的设计哲学完全不同。它把上面所有环节都内化为平台能力,开发者只需要一个 API 调用,就能得到直接可用的结构化数据。 更重要的是,它内置了 MCP 协议(Model Context Protocol),AI 代理可以直接通过标准接口调用 XCrawl 的能力,不需要任何胶水代码。
从 GitHub 上的 x-crawl 开源版本,到现在云端托管的 XCrawl API 服务,这个产品经历了从开发者工具到企业级平台的完整演变。 目前,XCrawl 已经成为 OpenClaw 生态中最受欢迎的数据抓取工具之一,在中文开发者社区中口碑持续发酵。
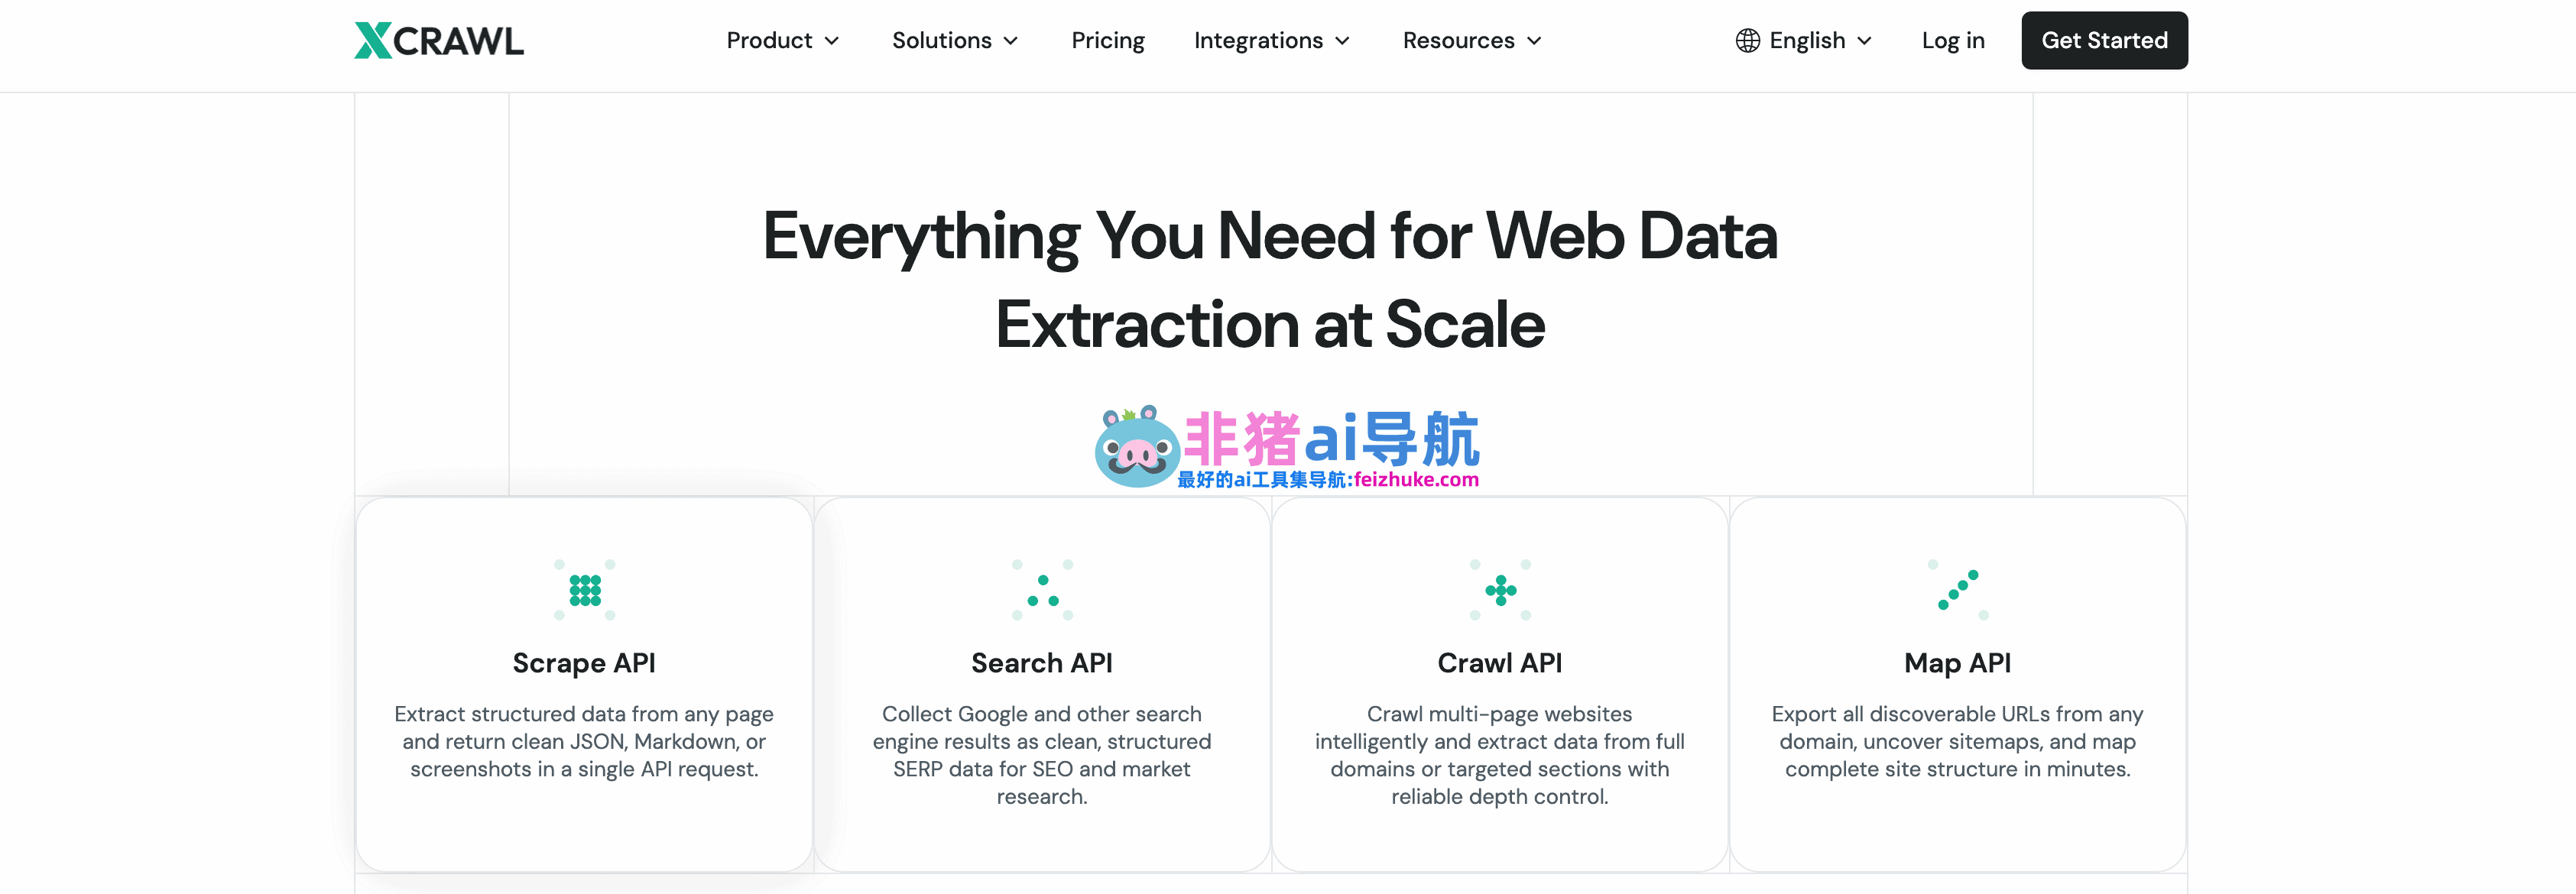
四大核心 API,覆盖完整数据采集链
XCrawl 的产品架构以四个核心 API 为骨架,每个模块解决一类具体问题,组合使用可以覆盖几乎所有 Web 数据采集场景。
Scrape API:单页精准抓取
这是最基础也是使用频率最高的能力。给一个 URL,Scrape API 会返回该页面的结构化数据。
输出格式支持三种:
- JSON:自动识别页面中的表格、列表、文章段落等结构化元素,直接输出干净的 JSON,无需手写解析规则
- Markdown:将页面内容转换为 LLM 友好的 Markdown 格式,保留语义结构,去除无关噪音
- Screenshot:返回页面截图,适合视觉验证或需要保留原始页面外观的场景
XCrawl 的智能解析引擎能自动识别不同类型网站的内容结构,无论是电商商品详情、新闻文章、技术文档还是社交媒体内容,都能精准提取核心信息,而不是返回一坨杂乱的 HTML 代码。
对于 JavaScript 动态渲染的页面,Scrape API 内置了无头浏览器支持,能等待页面完全渲染后再抓取,彻底解决 SPA 应用数据抓不到的历史痛点。
Crawl API:全站智能爬取
如果说 Scrape API 是精准狙击,那 Crawl API 就是地毯式覆盖。
给定一个域名或起始 URL,Crawl API 会自动发现并遍历网站内的所有相关页面,支持深度控制和定向抓取配置。你可以指定爬取深度、限定路径范围、设置页面数量上限,让爬虫只抓你真正需要的那部分内容。
这对于需要构建企业知识库、产品数据库、竞品监控系统的场景来说,价值极大。以往做这类工作需要自己搭 Scrapy 集群,维护调度系统、代理池、去重逻辑,光基础设施就要折腾好几天。用 Crawl API,一个调用就能搞定整站数据采集。
Search API(SERP API):搜索引擎结构化数据采集
这个模块专门用于采集搜索引擎结果页面(SERP)的结构化数据。
对于做 SEO 研究、关键词追踪、竞品排名监控、市场调研的团队来说,SERP 数据是核心原材料。XCrawl 的 Search API 能返回干净的结构化搜索结果,包括标题、URL、摘要、排名位置等字段,直接可用于分析,省去了自己解析 SERP 页面的麻烦。
Map API:网站结构映射
Map API 解决的是一个更底层的问题:在正式爬取之前,先搞清楚一个网站的 URL 结构。
输入一个域名,Map API 会返回该网站所有可发现的 URL 列表,相当于给整个网站做一次”地图测绘”。这对于制定爬取策略、评估工作量、发现隐藏内容路径都非常有用。
技术底座:绕过反爬不再是难题
一个爬虫工具好不好用,很大程度上取决于它在面对现代反爬机制时的实际表现。这也是 XCrawl 最让人印象深刻的地方。
全球动态住宅 IP 池
XCrawl 内置全球动态住宅 IP 代理池,能自动轮换 IP,完美模拟真实用户的网络行为。 与数据中心 IP 不同,住宅 IP 来自真实的互联网用户设备,被识别为爬虫的概率极低。
这意味着用户不需要自己维护代理池,不需要购买代理套餐,不需要处理 IP 封禁和轮换逻辑。所有这些都由 XCrawl 在底层自动处理,对上层完全透明。
智能浏览器指纹
现代网站的反爬系统不只看 IP,还会分析浏览器指纹——包括 User-Agent、屏幕分辨率、字体列表、WebGL 渲染信息、Canvas 指纹等几十个维度。
XCrawl 内置智能浏览器指纹生成系统,能为每次请求生成真实可信的浏览器环境特征,有效规避 Cloudflare、reCAPTCHA、DataDome 等主流反爬盾的检测。实测综合爬取成功率稳定在 90% 以上,在高对抗场景下表现尤为突出。
JavaScript 渲染支持
对于使用 React、Vue、Angular 等现代框架构建的单页应用,XCrawl 内置无头浏览器能力,能完整执行页面 JavaScript,等待动态内容加载完成后再提取数据。 这解决了传统 HTTP 请求爬虫面对 SPA 应用时的根本性缺陷。
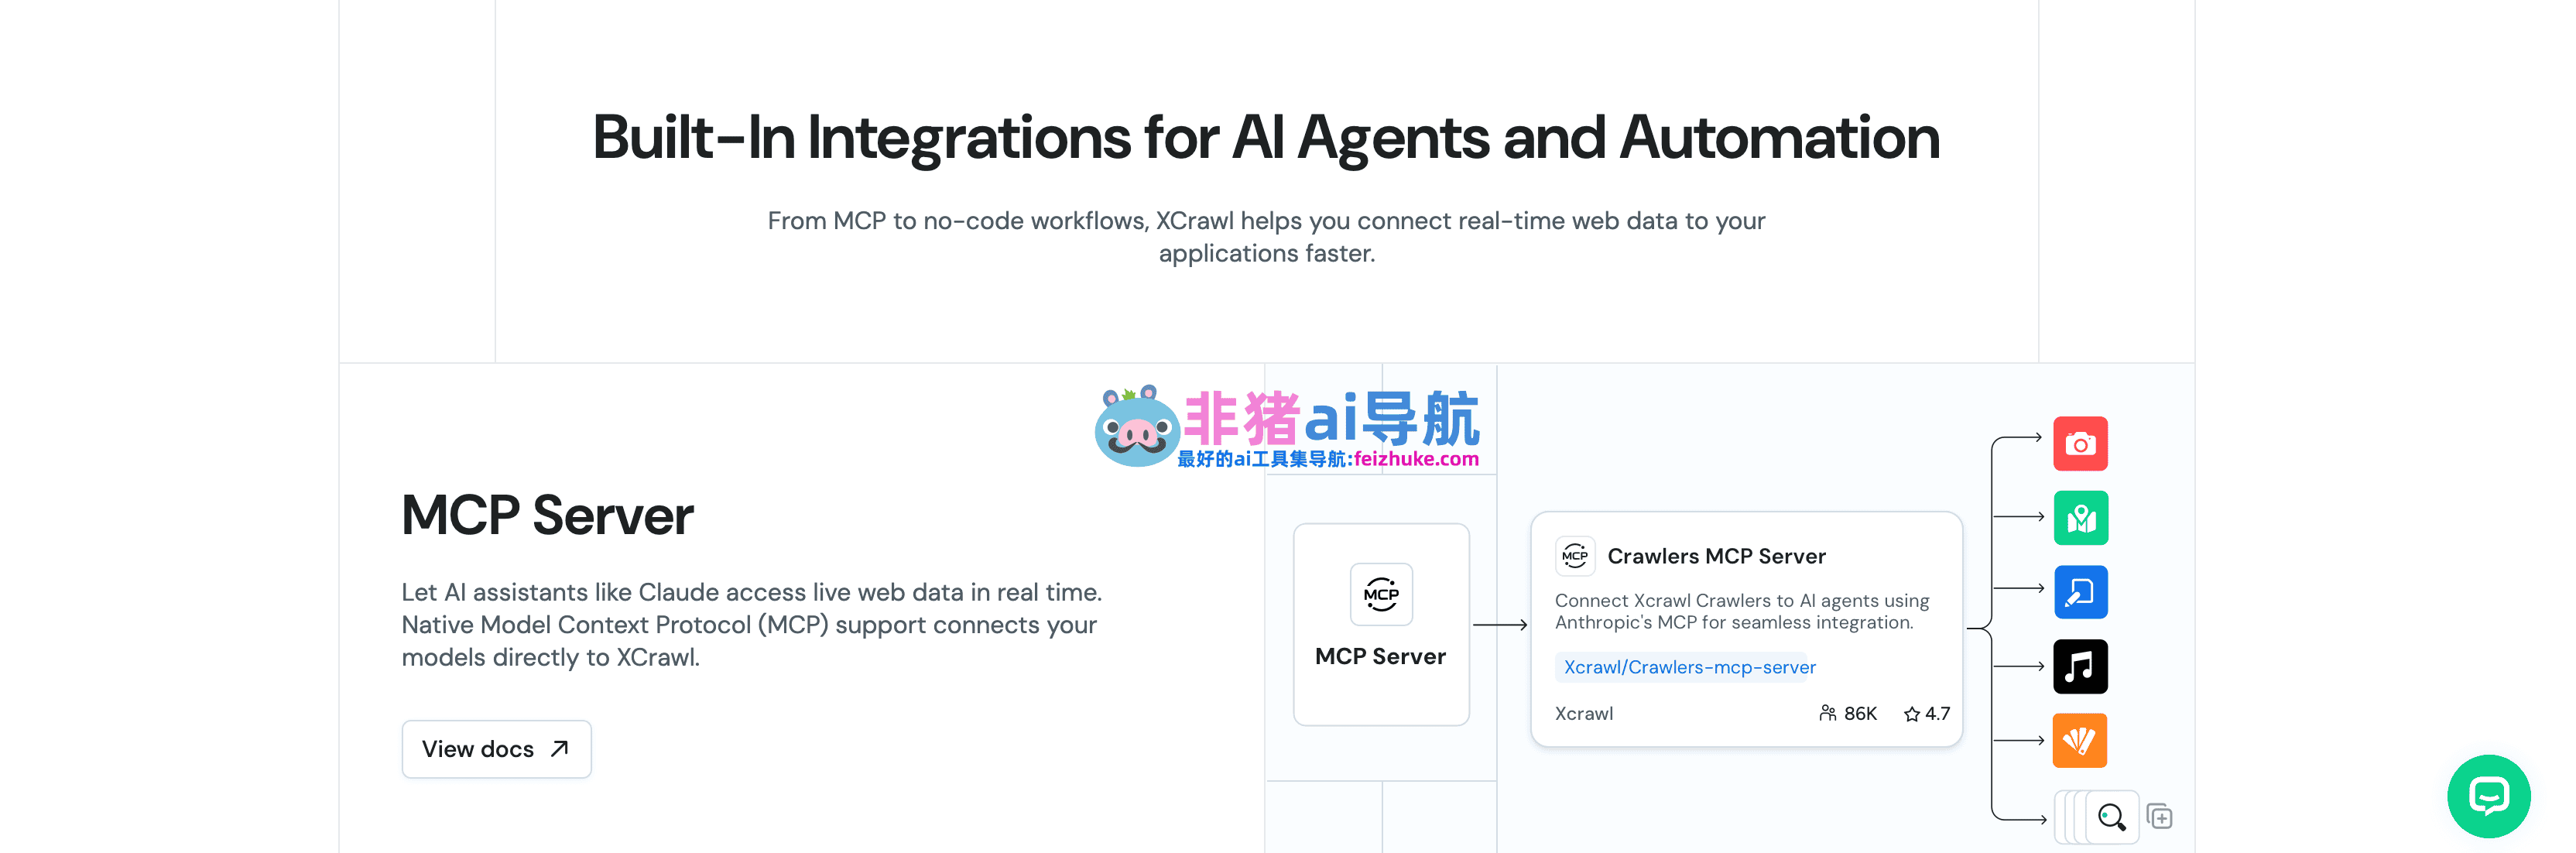
MCP 协议:让 AI 代理直接”看网页”
这是 XCrawl 在 2026 年最具前瞻性的一个特性。
MCP(Model Context Protocol)是由 Anthropic 主导推广的标准化协议,目标是让 LLM 能够以标准化方式调用外部工具和数据源。 随着 Claude、GPT-4 等大模型在 AI 代理场景中的广泛应用,MCP 正在成为 AI 工具生态的基础设施层。
XCrawl 原生支持 MCP 协议,这意味着什么?
- 你可以在 Claude、OpenClaw、ClaudeCode 等支持 MCP 的 AI 平台中,直接安装 XCrawl 的 skill(技能包)
- AI 代理能像调用本地工具一样调用 XCrawl 的 scrape、crawl、search、map 四个核心功能
- 所有输出都是标准化的 Markdown 或 JSON 格式,大幅降低 Token 消耗,最多可节省约 70% 的处理成本
- 整个数据流——从网页抓取到 LLM 分析——在一个统一的 API key 下运行,无需额外的格式转换和中间件
有开发者在 X(原 Twitter)上分享了使用体验:以前习惯把工具分开接,Firecrawl 抓单页,Tavily 搜索,Jina 爬内容,现在只需要一个 XCrawl 就能全部搞定,而且通过 MCP 协议在 AI 代理框架中的集成体验更流畅。

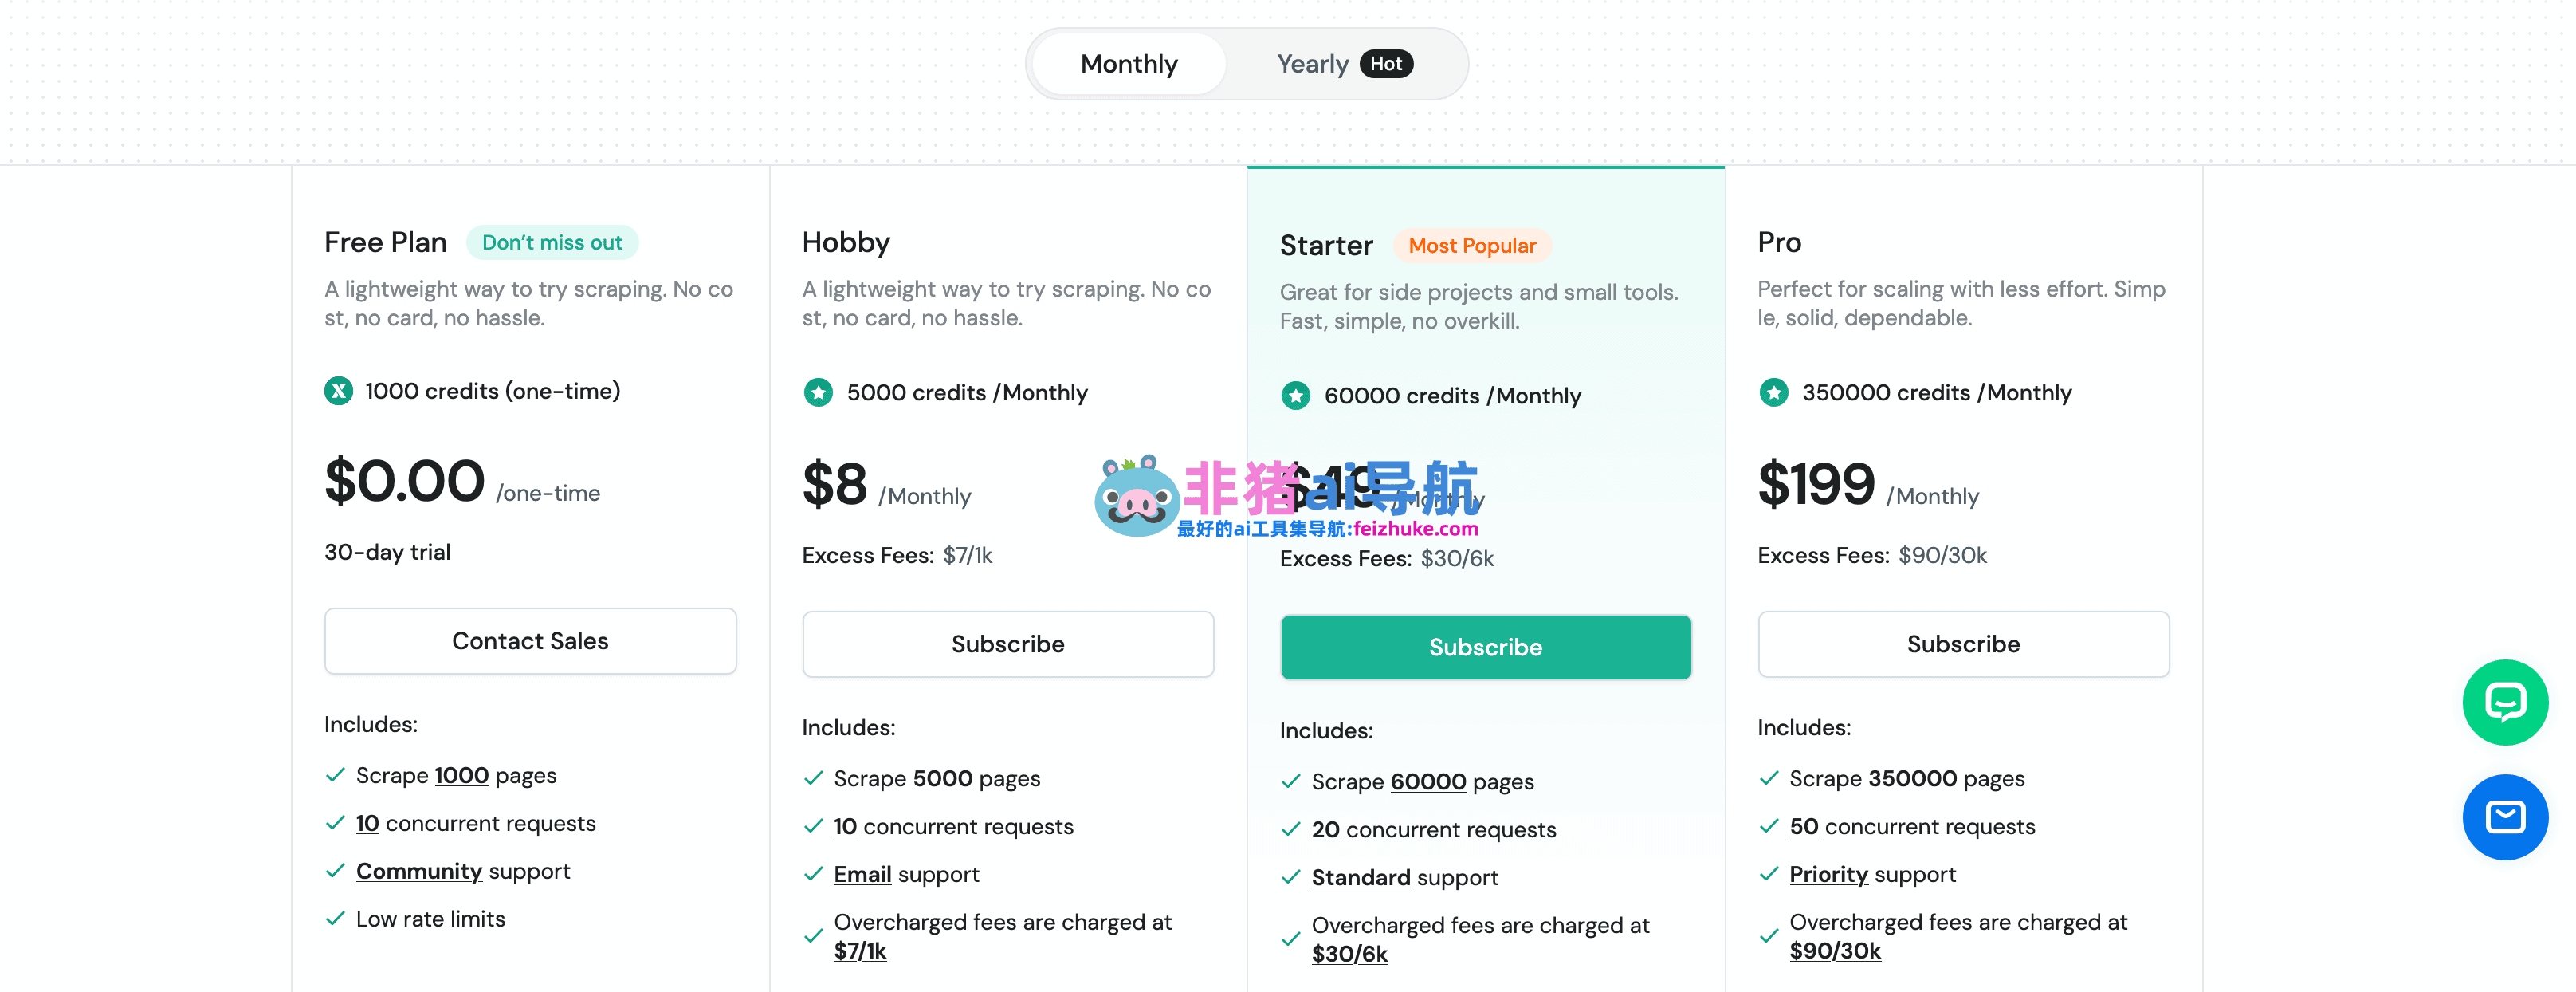
定价:从免费起步,按需扩展
XCrawl 采用积分制计费模型,提供从免费到企业级的完整梯度。
| 套餐 | 月费 | 积分额度 | 并发数 | 适用场景 |
|---|---|---|---|---|
| Free | $0 | 1,000 积分(一次性) | 10 | 个人测试、功能评估 |
| Hobby | $8 | 月度积分包 | 较高 | 个人项目、小规模采集 |
| 更高套餐 | 按需定价 | 更大额度 | 更高 | 企业级、高频采集 |
新用户注册即获得 1,000 积分免费额度,可以用来测试所有核心 API 功能,评估是否符合需求。 与市场上其他竞品相比,XCrawl 的定价相当有竞争力,尤其是考虑到它内置了代理池、指纹管理、MCP 集成等通常需要额外付费的能力。

开源版 x-crawl:给想要完全掌控权的开发者
除了云端 API 服务,XCrawl 还有一个功能完整的开源 Node.js 版本,托管在 GitHub 上(coder-hxl/x-crawl)。
开源版的主要特性:
- AI 辅助爬取:集成 OpenAI 和 Ollama,可以用自然语言描述想要提取的数据,AI 自动生成解析逻辑
- 异步/同步双模式:通过
mode参数一键切换,无需修改爬取逻辑 - 设备指纹伪装:内置零配置指纹管理,也支持自定义配置
- 页面自动化控制:支持键盘输入、鼠标事件、元素等待等自动化操作
- 多目标批量处理:支持同时爬取多个 URL,内置重试机制(
maxRetry)和请求间隔控制(intervalTime)
一个典型的使用示例——自动获取图片资源:
import { createCrawl, createCrawlOpenAI } from 'x-crawl'

const crawlApp = createCrawl({
  maxRetry: 3,
  intervalTime: { max: 2000, min: 1000 }
})

const crawlOpenAIApp = createCrawlOpenAI({
  clientOptions: { apiKey: process.env['OPENAI_API_KEY'] },
  defaultModel: { chatModel: 'gpt-4-turbo-preview' }
})

crawlApp.crawlPage('https://example.com/listings').then(async (res) => {
  const { page, browser } = res.data
  await page.waitForSelector('[data-tracking-id="LISTINGS"]')
  const html = await page.$eval('[data-tracking-id="LISTINGS"]', el => el.innerHTML)

  // 用 AI 解析出图片链接并去重
  const result = await crawlOpenAIApp.parseElements(html, '获取图片链接,去重')
  browser.close()

  crawlApp.crawlFile({
    targets: result.elements.map(item => item.src),
    storeDirs: './images'
  })
})
开源版适合需要本地部署、深度定制、完全数据主权的场景。云端 API 版则适合不想维护基础设施、追求开发效率的团队。
真实使用场景拆解
场景一:AI 知识库构建
许多团队在构建 RAG(检索增强生成)系统时,第一个问题就是数据从哪来。用 XCrawl 的 Crawl API 对目标网站做全站爬取,输出 Markdown 格式,可以直接送入向量数据库,省去了 HTML 清洗和格式转换两个步骤。
场景二:竞品监控与价格追踪
电商、SaaS 公司经常需要监控竞品的价格变动、功能更新、用户评价。XCrawl 的 Scrape API 配合定时调度,能建立起自动化的竞品情报采集系统。结构化的 JSON 输出让数据直接入库,无需额外处理。
场景三:SEO 数据分析
Search API 能批量采集关键词的 SERP 数据,结合 AI 分析可以快速识别排名机会、竞争格局、内容缺口。对于独立站运营者和 SEO 从业者来说,这是一个性价比极高的数据来源。
场景四:AI 代理工具调用
这是最前沿的使用场景。通过 MCP 协议,XCrawl 可以作为 AI 代理的”眼睛”,让 Claude 或 GPT 能够实时获取任何网页的最新内容,执行网络调研任务,无需人工介入。
与同类产品详细对比
当前市场上主要的 AI 爬虫和 Web 数据 API 产品包括 Firecrawl、Jina Reader、Crawl4AI、Apify 和 Scrapfly。下面从多个维度做详细对比。
Firecrawl
Firecrawl 是目前市场上知名度最高的 AI 爬虫 API,GitHub Star 超过 70,000,支持 Python、Node.js、Go、Rust 多语言 SDK。 它的核心优势在于 Markdown 输出质量极高,对 LLM 工作流的适配非常完善,支持整站爬取、结构化提取、搜索等功能,产品矩阵与 XCrawl 高度重叠。
主要定价:免费版提供 500 积分(一次性),Hobby 套餐 $16/月 含 3,000 积分,Standard 套餐 $83/月 含 100,000 积分,Growth 套餐 $333/月 含 500,000 积分。
从定价角度看,Firecrawl 在中等使用量下明显贵于 XCrawl(Hobby 套餐 $16 vs XCrawl 的 $8)。 功能上,Firecrawl 的生态更成熟,文档和社区资源更丰富,但 MCP 原生支持的深度不如 XCrawl,对 AI 代理框架的集成需要更多配置。
Jina Reader
Jina Reader 是 Jina AI 推出的单页 Markdown 提取服务,使用自研的 ReaderLM-v2 模型做内容转换。 它的最大优势是免费——基础的单页内容读取完全免费,对个人开发者极为友好。
但 Jina Reader 的局限性也很明显:它只做单页提取,不支持全站爬取;没有 SERP 采集能力;反爬能力较弱,面对有保护的网站经常失手;也没有原生 MCP 支持。 对于需要多功能覆盖的场景,Jina Reader 更像是一个补充工具,而非完整解决方案。
Crawl4AI
Crawl4AI 是一个以 Python 为主的开源爬虫库,GitHub Star 超过 58,000,专注于本地 LLM 集成和 RAG 流水线场景。 它支持 async 并发爬取,输出针对 LLM 做了优化,完全开源免费,是技术能力较强的个人开发者和研究者的热门选择。
缺点是部署和维护需要一定技术门槛,没有托管服务,反爬能力依赖用户自行配置代理,也没有 SERP API 和 Map API 功能。 适合本地部署、数据隐私要求高的场景,但在开发效率和功能完整性上不如 XCrawl 的云端 API 服务。
Apify
Apify 是爬虫赛道的老牌玩家,提供一个完整的爬虫市场(Actor Marketplace),用户可以直接使用别人写好的爬虫脚本,也可以发布自己的脚本。 它的优势在于生态极其丰富,针对 Amazon、Instagram、LinkedIn 等主流平台有专门的现成爬虫,即用即走。
但 Apify 的定价偏高,对于通用网页数据采集场景不如专门的 API 产品高效。它的输出格式不像 XCrawl 那样天然 LLM-ready,需要额外的数据处理步骤。MCP 集成支持也相对滞后。对于需要快速集成进 AI 工作流的团队,Apify 的上手成本更高。
Scrapfly
Scrapfly 是一个专注于反爬绕过能力的云端爬虫 API,在处理高对抗网站方面有独到之处。 它支持 JavaScript 渲染、代理轮换、浏览器指纹管理,在专业爬虫工程师中有较好口碑。
然而 Scrapfly 的定价偏高,而且输出以原始 HTML 为主,LLM-ready 的结构化输出能力不如 XCrawl。它也没有原生 MCP 支持,SERP API 功能不完善。对于纯粹需要绕过反爬获取原始数据的场景,Scrapfly 是很好的选择;但如果目标是构建 AI 工作流,XCrawl 的整体方案更加完整。
五款产品横向对比
| 维度 | XCrawl | Firecrawl | Jina Reader | Crawl4AI | Apify |
|---|---|---|---|---|---|
| 全站爬取 | ✅ | ✅ | ❌ | ✅ | ✅ |
| SERP API | ✅ | ✅ | ❌ | ❌ | 部分 |
| Map API | ✅ | ✅ | ❌ | ❌ | ❌ |
| MCP 原生支持 | ✅ 深度集成 | 部分 | ❌ | ❌ | ❌ |
| 反爬能力 | ✅ 住宅IP+指纹 | ✅ | ❌ 较弱 | ⚠️ 需自配 | ✅ |
| JS 渲染 | ✅ | ✅ | 部分 | ✅ | ✅ |
| LLM-ready 输出 | ✅ JSON/Markdown | ✅ | ✅ Markdown | ✅ | ⚠️ 需处理 |
| 免费额度 | 1,000 积分 | 500 积分 | 无限单页 | 完全免费 | 有限 |
| Hobby 月费 | $8 | $16 | 按量计费 | 开源免费 | $49+ |
| 开源版本 | ✅(Node.js) | ✅ | ✅ | ✅ | 部分 |
| 托管云服务 | ✅ | ✅ | ✅ | ❌ | ✅ |
| 截图功能 | ✅ | ✅ | ❌ | ✅ | ✅ |
上手体验与实测感受
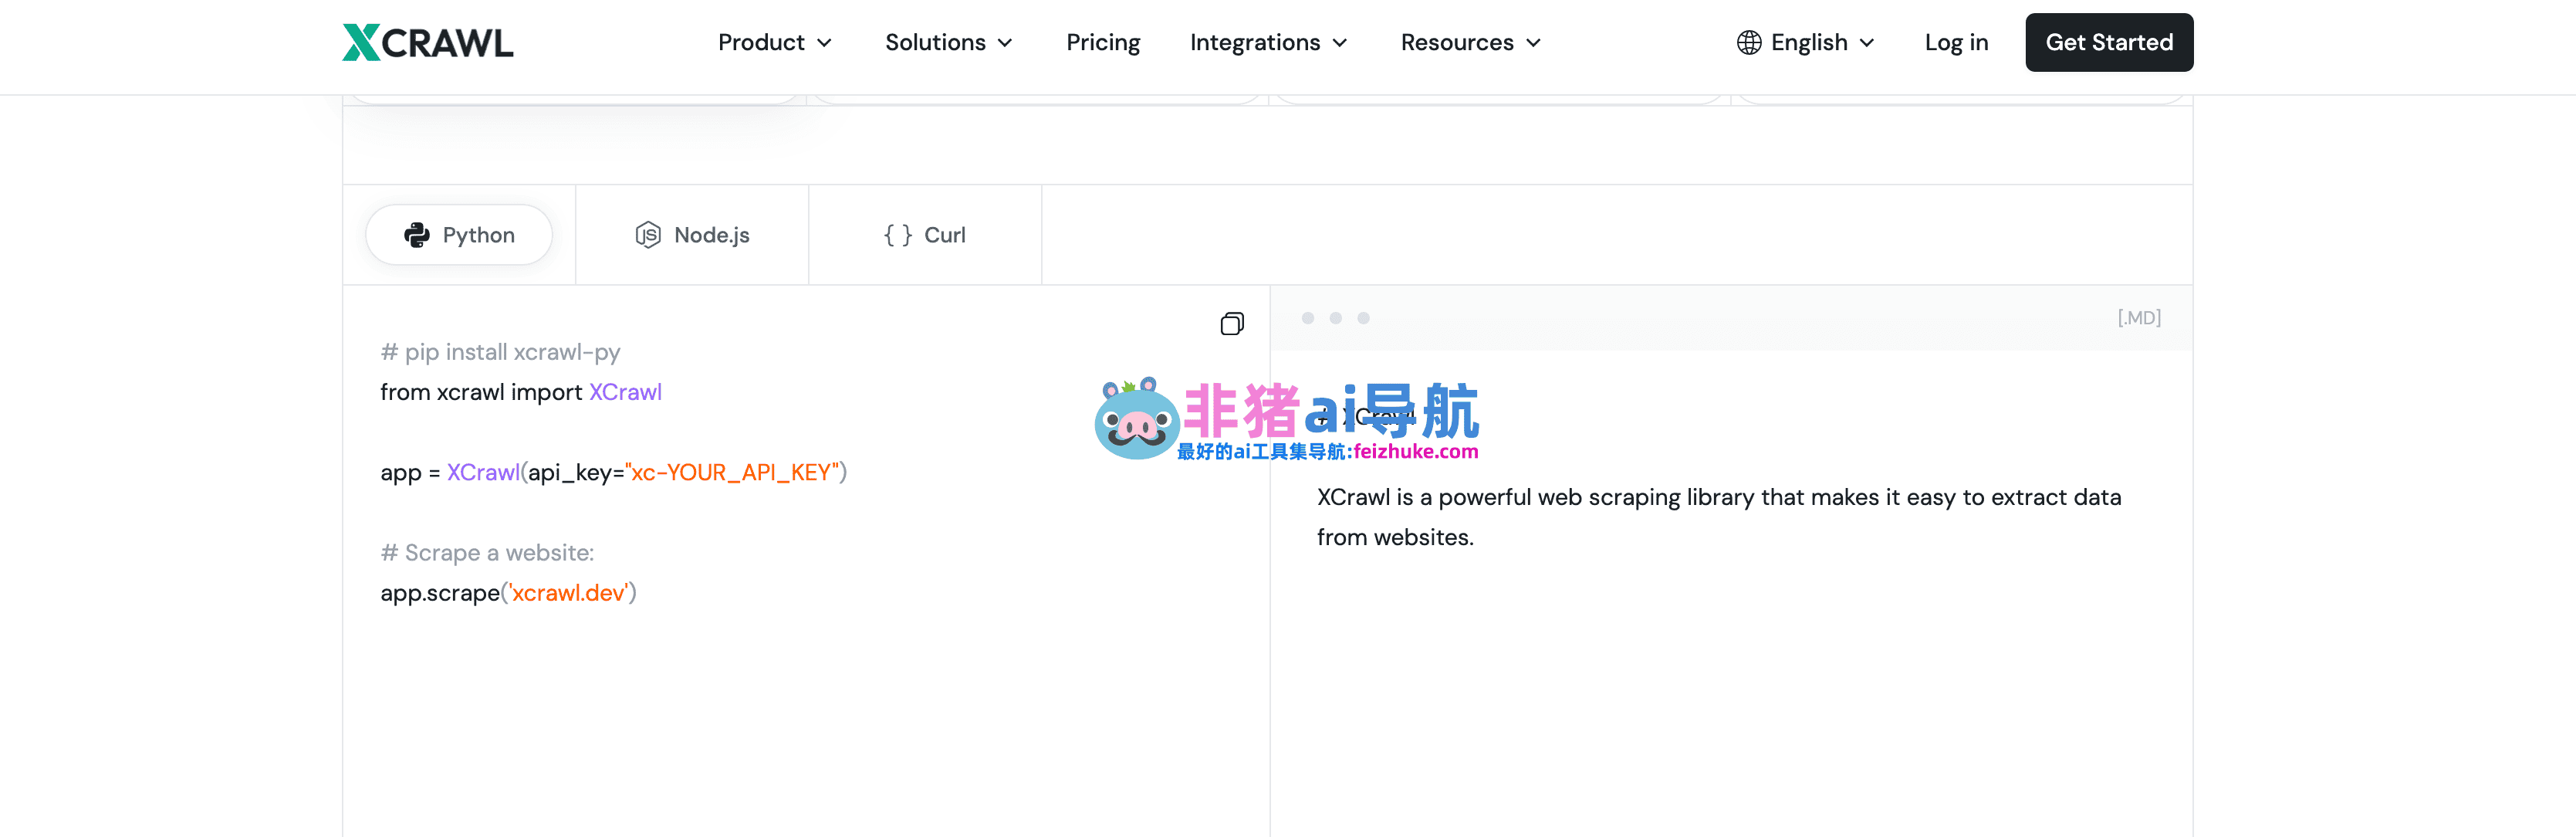
从实际使用角度来看,XCrawl 的 API 设计相当简洁直观。一个基本的 Scrape 请求只需要几行代码,连 API 文档都不用反复翻,参数命名见名知义。
以 Scrape API 为例,一次标准的调用流程如下:
- 注册账号,获取 API Key
- 通过 HTTP POST 请求调用
/scrape端点,传入目标 URL 和输出格式参数 - 返回结构化的 JSON 或 Markdown 数据,直接可用
对于 MCP 集成,操作同样简单:在支持 MCP 的 AI 平台(如 OpenClaw、Claude Desktop)中添加 XCrawl 的 skill 包,配置 API Key,AI 代理就能自动发现并调用 XCrawl 的四个核心工具。 整个配置过程 5 分钟内可以完成,不需要编写任何自定义集成代码。
实测几个关键维度的表现:
- 反爬成功率:在电商、新闻、社交媒体等常见目标站点,成功率稳定在 90% 以上,Cloudflare 保护的页面基本都能正常抓取
- 输出质量:Markdown 输出干净,噪音低,表格和列表结构保留完整,直接粘贴进 Claude 或 GPT 的 prompt 不需要任何二次清理
- 响应速度:单页抓取通常在 2-5 秒内返回,复杂的 JS 渲染页面会慢一些,但总体在可接受范围内
- 全站爬取稳定性:深度爬取时偶发超时,但内置重试机制能自动处理大多数情况
谁应该用 XCrawl
非常适合的人群:
- 在构建 AI 代理、RAG 系统、LLM 应用的开发者,需要给 AI 提供实时网络数据
- 独立开发者和小团队,不想维护爬虫基础设施,需要开箱即用的解决方案
- SEO 从业者和数据分析师,需要批量采集 SERP 数据和竞品信息
- 在 Claude、OpenClaw 等 MCP 生态中工作的 AI 工程师,希望一键获得实时网页数据能力
可能有更好选择的场景:
- 如果你的预算极度有限,且只需要单页 Markdown 提取,Jina Reader 的免费额度可能够用
- 如果你需要针对特定平台(Amazon、Instagram 等)的现成爬虫模板,Apify 的 Actor 市场可能更方便
- 如果你需要完全本地化部署且有较强技术能力,开源版 x-crawl 或 Crawl4AI 是更好的选择
产品演进与生态布局
XCrawl 的发展轨迹很清晰:从一个 GitHub 上的 Node.js 爬虫库,逐步演进为一个面向 AI 时代的完整 Web 数据平台。
这背后的驱动力是 AI 工作流的爆发性增长。2025-2026 年,以 Claude、GPT-4o、Gemini 为代表的大模型在企业和个人开发者中的渗透率急速提升,AI 代理(AI Agent)从概念走向大规模落地,”给 AI 提供实时网络数据”成为一个巨大的基础设施需求。
XCrawl 的 MCP 原生支持就是在这个背景下推出的,而且比大多数竞品都更早、更彻底。 这种前瞻性让它在 AI 代理生态中占据了有利位置——当越来越多的 AI 平台采用 MCP 作为工具集成标准时,XCrawl 已经可以无缝接入,而竞品还在处理适配问题。
从 GitHub 的 xcrawl-api/xcrawl-skills 仓库也能看出产品方向:XCrawl 正在主动为多 Agent 运行时环境提供生产级的 skill 定义,覆盖 scrape、map、crawl、search 四个核心功能,为不同的 AI 代理框架提供统一的接入方式。
技术架构的几个设计亮点
统一输出格式的价值
XCrawl 强制所有输出走 JSON 或 Markdown 两种标准格式,拒绝返回原始 HTML。这个看似简单的设计决策,实际上消除了数据流水线中最耗时的清洗环节。 对于每天要处理大量网页数据的 AI 系统来说,这个差异在积累效应下相当显著。
单 API Key 多功能统一
所有功能(scrape、crawl、search、map)共用同一个 API Key,积分跨功能通用。 这看起来只是个小细节,但在实际工程中意义很大——不需要管理多套鉴权,不需要在不同工具间切换上下文,系统架构更简洁。
请求级代理与指纹管理
代理和指纹的分配是请求级别的,每次抓取都能获得独立的网络身份,最大程度降低被识别为爬虫的风险。 这比很多竞品的账号级或会话级代理管理粒度更细,对于需要高频访问同一目标站点的场景,效果尤为明显。
对比之下,XCrawl 的真正护城河在哪里
盘点下来,XCrawl 在当前市场中最难被复制的优势有两个:
第一是 MCP 生态的先发优势。 在 AI 代理这个赛道,工具与主流 AI 平台的集成深度决定了它能触达多大的用户群体。XCrawl 对 MCP 的深度支持,让它能够自然地嵌入 Claude、OpenClaw 等主流 AI 工作流,这种网络效应一旦形成,就很难被后来者打破。
第二是”四合一”的完整性。 Scrape + Crawl + Search + Map,四个模块在一个平台内统一,用同一个 key,走同一套定价,对于需要构建完整数据采集系统的团队来说,这种整合价值是巨大的。相比之下,很多竞品只解决其中一两个问题,用户不得不自己拼合多个工具,维护成本和稳定性风险都要高得多。
写在最后之前:几个值得关注的细节
使用 XCrawl 之前,有几点值得提前了解:
- 合规使用是前提。XCrawl 明确要求用户遵守目标网站的
robots.txt规定,仅用于合法目的。强大的反爬能力不是绕过网站服务条款的理由,使用前务必确认采集行为的合规性。 - 积分消耗要测算清楚。不同 API 和不同输出格式的积分消耗不同,正式上生产前最好先用免费额度测算一下自己的使用量,避免上线后账单超预期。
- 网络延迟因地区而异。云端 API 服务的响应速度受服务器节点和用户地理位置影响,国内用户可能会感受到一些延迟,在时延敏感的场景下需要提前测试。
- 开源版与云端版的功能差异。开源的 x-crawl 是独立维护的 Node.js 库,功能和云端 API 版本不完全对应,不要把两者当作同一产品的本地/云端版本来理解,它们其实是两个不同发展方向的产品。
数据评估
关于Xcrawl特别声明
本站别摸鱼导航提供的Xcrawl都来源于网络,不保证外部链接的准确性和完整性,同时,对于该外部链接的指向,不由别摸鱼导航实际控制,在2026年3月30日 下午7:43收录时,该网页上的内容,都属于合规合法,后期网页的内容如出现违规,可以直接联系网站管理员进行删除,别摸鱼导航不承担任何责任。
相关导航
没有相关内容!

暂无评论...


